タイドローン協会

สมัครสมาชิก☰

Article

รวบรวทบทความทุกหมวดหมู่

อินโฟกราฟิก อัปเดตกฎหมายโดรน CAAT 2569 Specific Category การบันทึกสิทธิทำการผ่าน UAS Portal และการขออนุญาตบินกรณีพิเศษ
Law Article, Drone Article, ニュース

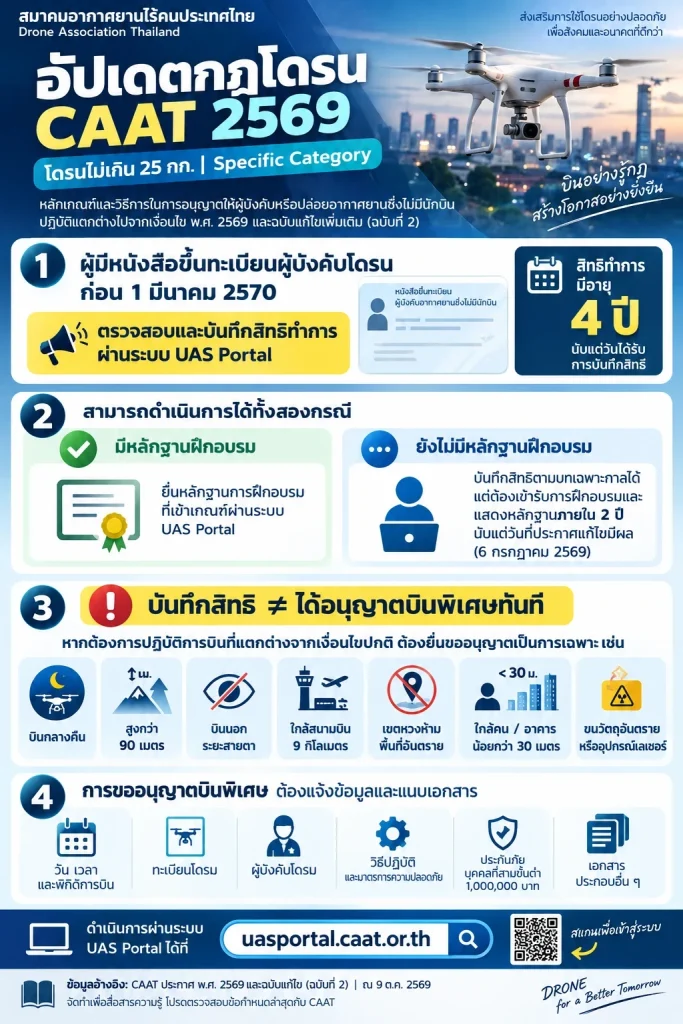
อัปเดตกฎหมายโดรน CAAT 2569 สิ่งที่ผู้บังคับโดรนต้องรู้! การบันทึกสิทธิทำการ และการขออนุญาตบินกรณีพิเศษ

สรุปประกาศ CAAT พ.ศ. 2569 และฉบับแก้ไข (ฉบับที่ 2) สำหรับโดรนไม่เกิน 25 กก.: ผู้ขึ้นทะเบียนก่อน 1 มี.ค. 2570 ต้องบันทึกสิทธิทำการ Specific Category ผ่าน UAS Portal (อายุ 4 ปี) และการบินแบบใดต้องขออนุญาตเป็นกรณีพิเศษ
อัปเดตกฎหมายโดรน CAAT 2569 สิ่งที่ผู้บังคับโดรนต้องรู้! การบันทึกสิทธิทำการ และการขออนุญาตบินกรณีพิเศษ 投稿を読む »

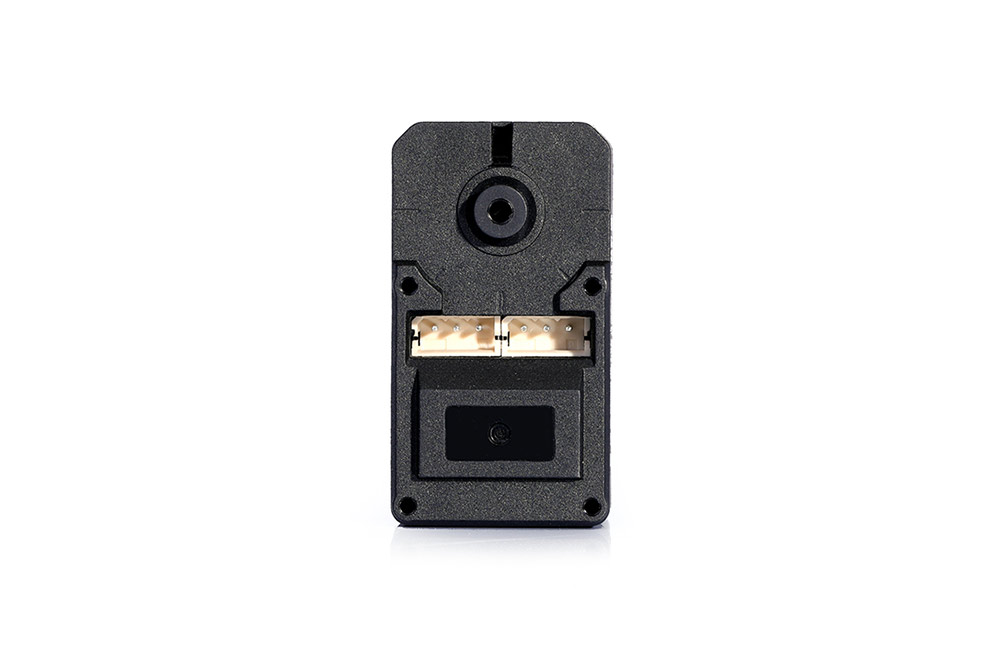
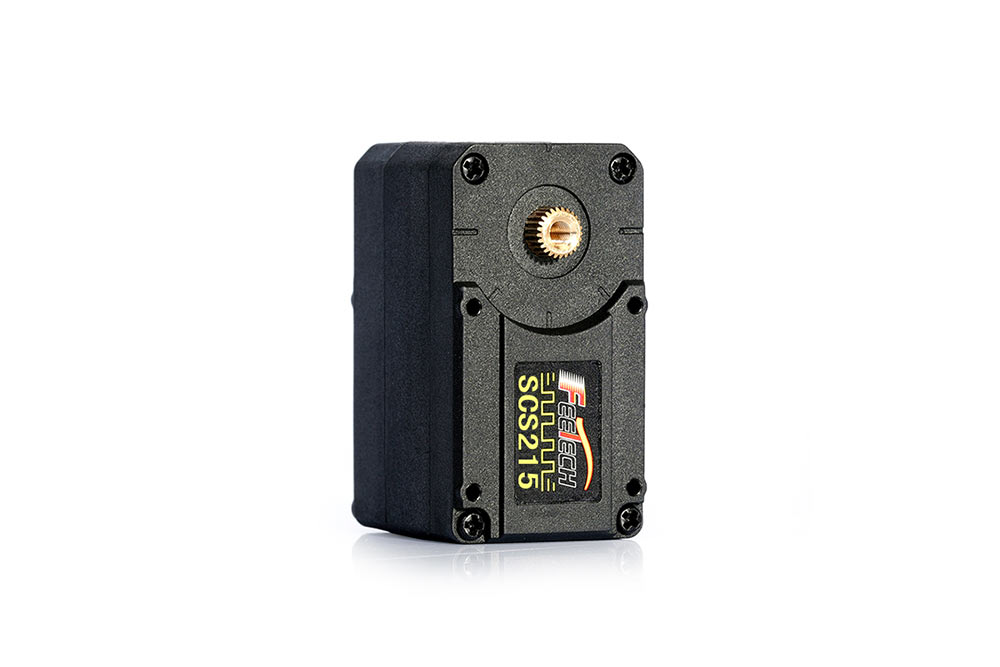
Feetech STS3215 มุมมองด้านข้าง
Humanoid Robot Article

เซอร์โว Feetech STS3215 และอะไหล่หุ่นยนต์เป็ด เทียบกับ Dynamixel XL330

หน้านี้รวมข้อมูล เซอร์โวและอะไหล่สำหรับหุ่นยนต์เป็ด ทั้งฝั่ง Microduck ที่ใช้ Dynamixel XL330 และฝั่ง Open Duck Mini v2 ที่ใช้ Feetech STS3215 พร้อมข้อควรระวังตอนสั่งซื้อที่ทำให้หลายคนได้ของผิดรุ่นมาแล้ว ถ้าอ่านไม่ไหวทั้งหน้า จำ 3 ข้อนี้พอ 1. คำตอบขึ้นกับ รุ่น ไม่ใช่ยี่ห้อ — STS3215 ใส่แทนใน Microduck ไม่ได้ เพราะใหญ่และหนักเกินไป 2. มีเซอร์โวบางรุ่นที่ใช้ทดแทนได้โดยปรับชิ้นส่วนยึดเล็กน้อย ต้องเลือกให้ตรงกับงาน ปรึกษาเราก่อนสั่งได้ 3. ถ้าจะประกอบ Open Duck Mini v2

เซอร์โว Feetech STS3215 และอะไหล่หุ่นยนต์เป็ด เทียบกับ Dynamixel XL330 投稿を読む »

เซอร์โว Feetech STS3215 7.4V 19kg.cm
Humanoid Robot Article

Open Duck Mini v2 ประกอบหุ่นยนต์เป็ดเอง ไม่ต้องรอคิว Microduck

Open Duck Mini v2 คือหุ่นยนต์เป็ดเดิน 2 ขาแบบโอเพนซอร์สที่ ประกอบเองได้ทั้งตัว ออกแบบโดย Antoine Pirrone วิศวกรจากทีม Pollen Robotics คนเดียวกับที่อยู่เบื้องหลัง Microduck ต่างกันตรงที่ตัวนี้ไม่ต้องรอคิว 6 เดือน เพราะคุณสั่งอะไหล่มาประกอบเองได้เลย สรุปเร็ว • ขนาด สูง 42 ซม. หนัก 2.1 กก. (ใหญ่กว่า Microduck เกือบเท่าตัว) • เซอร์โวหลัก Feetech STS3215 แรงดัน 7.4V แรงบิด 19

Open Duck Mini v2 ประกอบหุ่นยนต์เป็ดเอง ไม่ต้องรอคิว Microduck 投稿を読む »

NVIDIA TensorRT Model Connect
AI Server & Hardware

NVIDIA TensorRT Model Connect แปลง Hugging Face checkpoint สู่ C++ inference ใน 2 คำสั่ง

การดาวน์โหลด checkpoint จาก Hugging Face เป็นเรื่องง่าย แต่การนำไปฝังในบริการ C++ หุ่นยนต์ หรืออุปกรณ์ปลายทางมักต้องผ่านการ export หลายชั้นและเขียนโค้ดเฉพาะโมเดล NVIDIA เปิด public preview ของ TensorRT Model Connect (TRTMC) โครงการ open source ที่พาโมเดลที่รองรับจาก Hugging Face หรือไฟล์ในเครื่องไปสู่ TensorRT inference แบบ native C++ ได้ใน 2 คำสั่ง โดยไม่ต้องแปลงผ่าน ONNX ก่อน ภาพ:

NVIDIA TensorRT Model Connect แปลง Hugging Face checkpoint สู่ C++ inference ใน 2 คำสั่ง 投稿を読む »

Perplexity Lily inference engine บน Apple Silicon
AI Server & Hardware

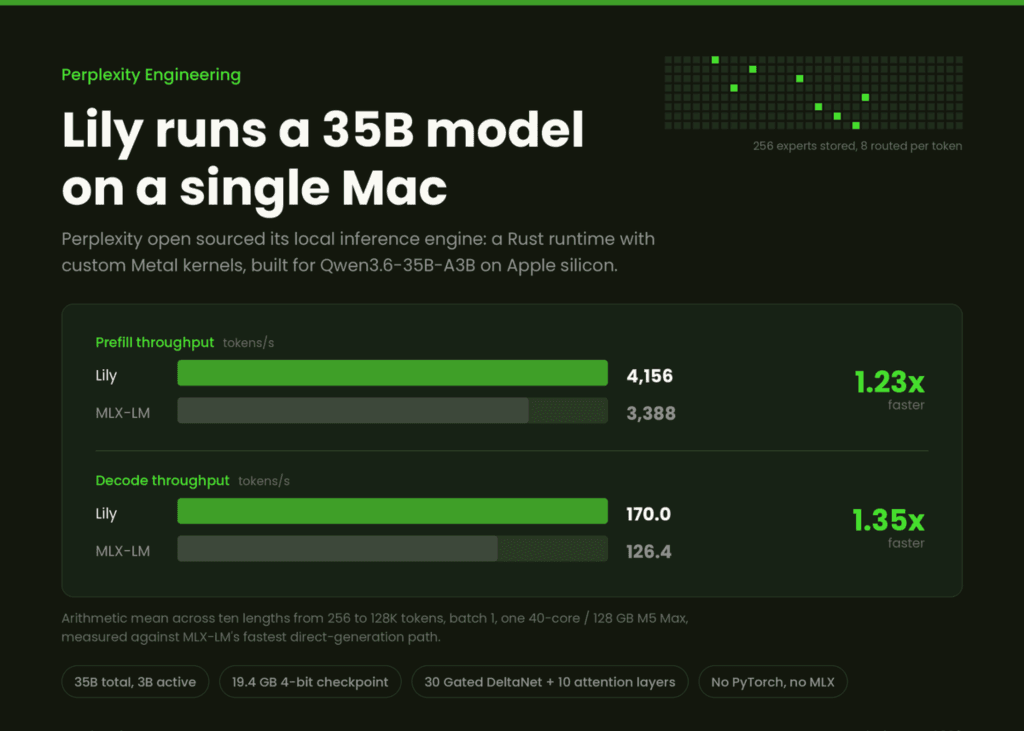
Perplexity เปิดซอร์ส Lily เอนจิน Rust และ Metal สำหรับรัน AI บน Apple Silicon

runtime ที่รองรับโมเดลจำนวนมากให้ความยืดหยุ่น แต่ต้องรักษาโค้ดให้ใช้ซ้ำข้ามสถาปัตยกรรม Perplexity เลือกอีกทางด้วย Lily inference engine ที่จงใจปรับเฉพาะโมเดล Qwen3.6-35B-A3B บน Apple silicon เพื่อรีดความเร็วจากโครงสร้างชิปและ unified memory โดยตรง โครงการนี้เป็นกลไก local inference เบื้องหลัง Hybrid Compute ของ Perplexity Computer และถูกเปิดซอร์สให้ทดลองผ่าน repository pplx-garden ภาพ: Perplexity ตัวระบบทำงานใน process เดียว ชั้น Rust โหลด checkpoint และควบคุมวงจรสร้างข้อความ ส่วน

Perplexity เปิดซอร์ส Lily เอนจิน Rust และ Metal สำหรับรัน AI บน Apple Silicon 投稿を読む »

Perplexity Hybrid Compute on Mac
AI Server & Hardware

Perplexity Hybrid Compute แบ่งงาน AI ระหว่างคลาวด์กับโมเดลใน Mac

AI agent จะมีประโยชน์มากขึ้นเมื่ออ่านเอกสารลูกค้า ไฟล์ข้อตกลง และข้อมูลภายในได้ แต่ข้อมูลเหล่านี้ก็เป็นสิ่งที่องค์กรไม่อยากส่งขึ้นคลาวด์ Perplexity จึงเปิด Hybrid Compute on Mac ให้ภารกิจเดียวแบ่งงานระหว่างโมเดลขนาดใหญ่บนคลาวด์กับโมเดลขนาดเล็กบน Mac โดยมี privacy gate ในเครื่องตัดสินว่าข้อมูลส่วนใดออกจากอุปกรณ์ได้ ภาพ: Perplexity ระบบเปิดใช้กับสมาชิก Pro, Max และ Enterprise บน Mac ที่ใช้ Apple silicon, ระบบ macOS 15 ขึ้นไป และ unified memory อย่างน้อย 24GB โดยแนะนำ

Perplexity Hybrid Compute แบ่งงาน AI ระหว่างคลาวด์กับโมเดลใน Mac 投稿を読む »

Anthropic Model Hardware Standard
AI Server & Hardware

Anthropic เปิดตัว MHS มาตรฐานกลางให้ AI agent ควบคุมอุปกรณ์จริงอย่างปลอดภัย

การให้ AI ช่วยตอบคำถามเป็นเรื่องหนึ่ง แต่การปล่อยให้ AI ขยับแขนกล ปรับเลเซอร์ หรือสั่งเครื่องมือในห้องทดลองเป็นอีกเรื่อง เพราะความผิดพลาดไม่ได้จบแค่คำตอบผิดบนหน้าจอ แต่อาจทำให้อุปกรณ์เสียหายหรือกระทบความปลอดภัยได้ Anthropic จึงเปิดโครงการวิจัย Model Hardware Standard (MHS) เพื่อสร้างภาษากลางระหว่าง AI agent กับอุปกรณ์จริง พร้อมกำหนดขอบเขตว่าระบบอ่านค่าอะไร ปรับอะไรได้ และต้องหยุดตรงไหน ภาพ: Anthropic เป้าหมายของ MHS ไม่ใช่สร้างหุ่นยนต์รุ่นใหม่ แต่แก้ปัญหาที่พบในห้องแล็บและสายการผลิตจำนวนมาก: เครื่องมือจากผู้ผลิตคนละรายมีอินเทอร์เฟซไม่เหมือนกัน ทีมงานจึงต้องเขียนซอฟต์แวร์เชื่อมต่อเป็นรายคู่ งานติดตั้งที่ Anthropic ระบุว่าเคยกินเวลาหลายสัปดาห์ถึงหลายเดือน อาจลดเหลือระดับชั่วโมงหรือนาทีเมื่ออุปกรณ์พูดผ่านมาตรฐานเดียวกัน Driver กลางทำให้ agent รู้จักเครื่องมือ แกนหลักของ

Anthropic เปิดตัว MHS มาตรฐานกลางให้ AI agent ควบคุมอุปกรณ์จริงอย่างปลอดภัย 投稿を読む »

LTX-2.5 world model สำหรับผลิตวิดีโอ
AI Server & Hardware

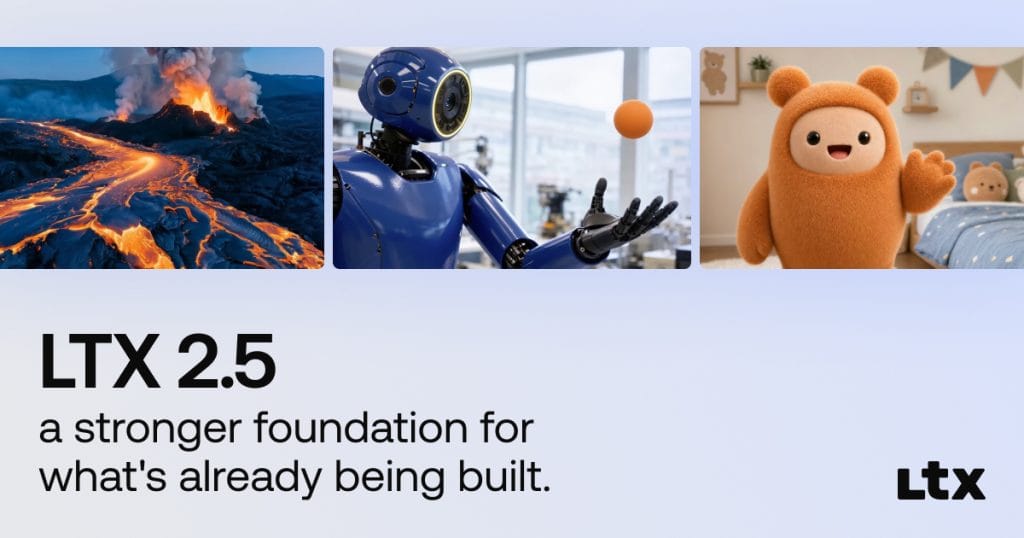
LTX-2.5 ยกชุดผลิตวิดีโอ AI มาไว้บนโต๊ะ เปิดเวทและเร่งความเร็วด้วย NVIDIA

การสร้างวิดีโอด้วย AI กำลังขยับจากบริการคลาวด์ที่คิดค่าบริการตามจำนวนครั้ง มาสู่เวิร์กสเตชันที่ผู้สร้างควบคุมเอง Lightricks เปิดตัว LTX-2.5 โมเดลแบบ open weights สำหรับสร้างวิดีโอ งานเรียลไทม์ และ physical AI โดยปรับให้ทำงานกับ NVIDIA RTX และ NVIDIA DGX Spark ได้ เป้าหมายคือย้ายขั้นตอนสร้าง ทดลอง และปรับแต่งงานมาอยู่บนเครื่องเดียว โดยไม่ต้องส่งทรัพย์สินทางปัญญาออกนอกระบบ ภาพ: Lightricks จุดขายไม่ได้อยู่แค่ “รันในเครื่อง” แต่เป็นการทำวิดีโอหลายช็อตให้ต่อเนื่องในครั้งเดียว รุ่นก่อนของโมเดลเปิดมักรักษาหน้าตาตัวละคร แสง หรือสไตล์ข้ามช็อตได้ยาก LTX-2.5 เพิ่ม native multishot generation

LTX-2.5 ยกชุดผลิตวิดีโอ AI มาไว้บนโต๊ะ เปิดเวทและเร่งความเร็วด้วย NVIDIA 投稿を読む »

Liquid AI Pipette ชุดทดสอบโมเดลบนอุปกรณ์
AI Server & Hardware

Liquid AI เปิด Pipette วัดโมเดล Quantization Runtime และฮาร์ดแวร์ในชุดเดียว

คะแนนบน model card บอกได้ว่าโมเดลเก่งเพียงใดภายใต้สภาพทดสอบหนึ่ง แต่ไม่ได้ตอบว่าเมื่อลดความละเอียดน้ำหนักแล้วนำไปรันบนโทรศัพท์หรือโน้ตบุ๊ก ผู้ใช้จะรอนานแค่ไหน เครื่องจะกินหน่วยความจำเท่าไร และคุณภาพจะตกลงมากน้อยเพียงใด Liquid AI จึงเปิดซอร์ส Pipette ชุด benchmark ที่ถือว่า “ระบบใช้งานจริง” คือผลรวมของโมเดล วิธี quantization, runtime และอุปกรณ์ ไม่ใช่ดูชื่อโมเดลแยกเดี่ยว ภาพ: Liquid AI โครงการนี้พัฒนาร่วมกับ Artificial Analysis ซึ่งทำหน้าที่ตรวจสอบวิธีวัดอย่างอิสระ ชุดข้อมูลเปิดตัวครอบคลุมตัวชี้วัดประสิทธิภาพบนอุปกรณ์ 5 รายการ มากกว่า 1,000 configurations จากโมเดลมากกว่า 30 รุ่น มี runtime

Liquid AI เปิด Pipette วัดโมเดล Quantization Runtime และฮาร์ดแวร์ในชุดเดียว 投稿を読む »

LFM2.5-DSpark speculative decoding
AI Server & Hardware

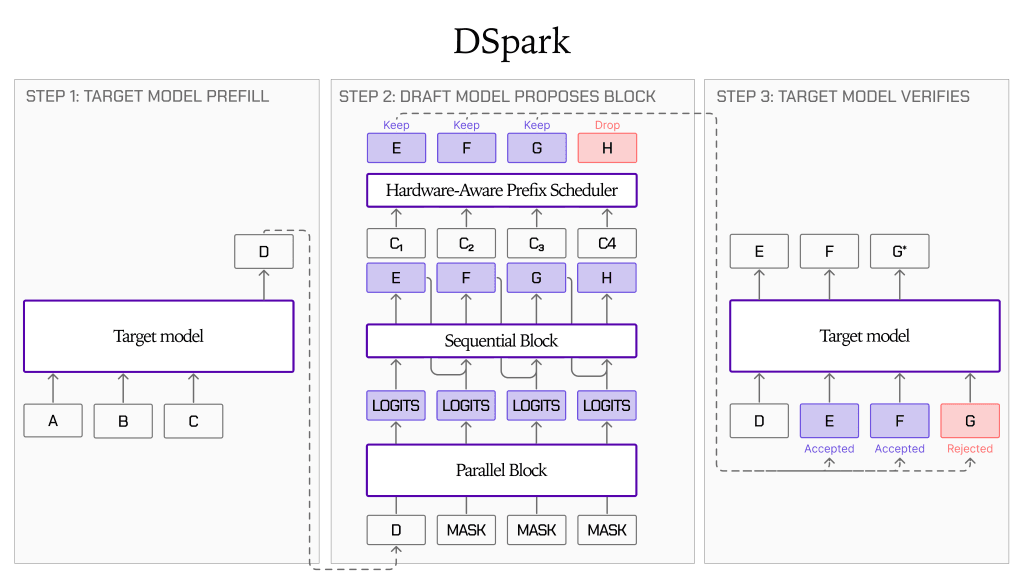
LFM2.5-DSpark ใช้โมเดลร่างเร่งการ Decode สูงสุด 3.18 เท่า โดยคำตอบไม่เปลี่ยน

เมื่อรันโมเดลภาษาในเครื่อง เวลาที่ผู้ใช้รอไม่ได้ขึ้นอยู่กับความเก่งของโมเดลเท่านั้น แต่ยังขึ้นกับความเร็วในการสร้าง token ทีละคำ Liquid AI เปิดตัว checkpoint ชุด LFM2.5-DSpark เพื่อเพิ่มเส้นทาง speculative decoding ให้โมเดล LFM2.5 สามรุ่น โดยรายงานความเร็วสูงสุด 3.18 เท่า บน NVIDIA H100 และ 2.87 เท่า บน MacBook Pro ชิป M4 Max จุดสำคัญคือในโหมด greedy decoding ลำดับคำตอบที่ปล่อยออกมายังคงเหมือนการรันโมเดลหลักเพียงตัวเดียว ภาพ: Liquid AI โมเดลที่รองรับประกอบด้วย

LFM2.5-DSpark ใช้โมเดลร่างเร่งการ Decode สูงสุด 3.18 เท่า โดยคำตอบไม่เปลี่ยน 投稿を読む »

上部へスクロール