
อัปเดต 24 สิงหาคม 2026
บทความนี้วิเคราะห์ฮาร์ดแวร์เชิงเทคนิคเพื่อการศึกษา ไม่ใช่คำแนะนำการลงทุนหรือการรับรองสินค้า ราคาและสถานะซอฟต์แวร์เปลี่ยนเร็วมาก โปรดตรวจสอบแหล่งอ้างอิงอีกครั้งก่อนตัดสินใจซื้อ
NVIDIA CMP 170HX คือการ์ดขุดคริปโตที่ถูกล็อกความสามารถไว้ตั้งแต่โรงงาน แต่ในปี 2026 เครื่องมือโอเพนซอร์สจากชุมชนทำให้การ์ดรุ่น 8GB บางใบ มองเห็น HBM2e ได้ถึงประมาณ 64GB พร้อมคืนกำลังคำนวณของ SM และเพิ่มลิงก์เป็น PCIe Gen 2 คำถามที่ตามมาคือ การ์ดที่เคยราคาไม่กี่ร้อยดอลลาร์นี้กลายเป็น “A100 ราคาถูก” สำหรับรัน Local AI ได้จริงหรือไม่ — คำตอบสั้น ๆ คือ ยังไม่ใช่ และบทความนี้จะอธิบายว่าเพราะอะไร
🎯 สรุปสั้นที่สุด ก่อนเข้าเนื้อหา
- 🔬ใช้ชิป GA100 ตระกูลเดียวกับ A100 แต่ไม่ใช่ A100 — จำนวน SM, PCIe, ECC, MIG, NVLink และการรับรองต่างกันทั้งหมด
- 🛠️ไม่ใช่การแฟลช VBIOS — เครื่องมือ cmpunlocker ทำงานผ่านโมดูลไดรเวอร์
nvidia-openที่แพตช์แล้ว - 💾รุ่น 8GB บางใบปลดเป็น ~64GB ได้ ส่วนรุ่น 10GB ใช้โปรไฟล์ 40GB ที่เน้นความเสถียรมากกว่า 80GB
- 💰ราคาปรับขึ้นแรงหลังข่าว ความคุ้มจึงต้องวัดจากต้นทุนทั้งระบบ ไม่ใช่ดูเฉพาะราคาต่อ GB
- ✅ข้อแนะนำหลัก — ซื้อหนึ่งใบที่ยืนยัน PCI ID และผล stress test ได้ก่อน แล้วทดสอบ workload จริง 24–72 ชั่วโมงก่อนขยายหลายใบ
- ทำไม CMP 170HX จึงกลับมาเป็นกระแสในวงการ AI?
- “ปลดล็อกเฟิร์มแวร์” จริง ๆ แล้วทำงานอย่างไร?
- สเปกที่สำคัญต่อการรัน AI
- ใช้ทำ AI อะไรได้บ้าง?
- ประสิทธิภาพเทียบกับ A100 และการ์ดเกม
- ข้อจำกัดสำคัญที่ต้องรู้ก่อนซื้อ
- ราคาในปี 2026 ยังเรียกว่า “ถูก” ได้หรือไม่?
- เช็กลิสต์ก่อนซื้อ 10 ข้อ
- วิธีประเมินความคุ้มค่าที่ถูกต้อง
- เหมาะกับใครและไม่เหมาะกับใคร
- บทสรุป
- よくある質問
1. ทำไม CMP 170HX จึงกลับมาเป็นกระแสในวงการ AI?
NVIDIA CMP 170HX เปิดตัวในยุคที่การขุด Ethereum กำลังเฟื่องฟู คำว่า CMP ย่อมาจาก Cryptocurrency Mining Processor ตัวการ์ดถูกออกแบบมาสำหรับงานขุดโดยตรง ไม่มีพอร์ตแสดงผล ใช้ระบบระบายความร้อนแบบ passive และถูกจำกัดความสามารถบางส่วนเพื่อไม่ให้แข่งขันกับผลิตภัณฑ์กลุ่มศูนย์ข้อมูลของ NVIDIA
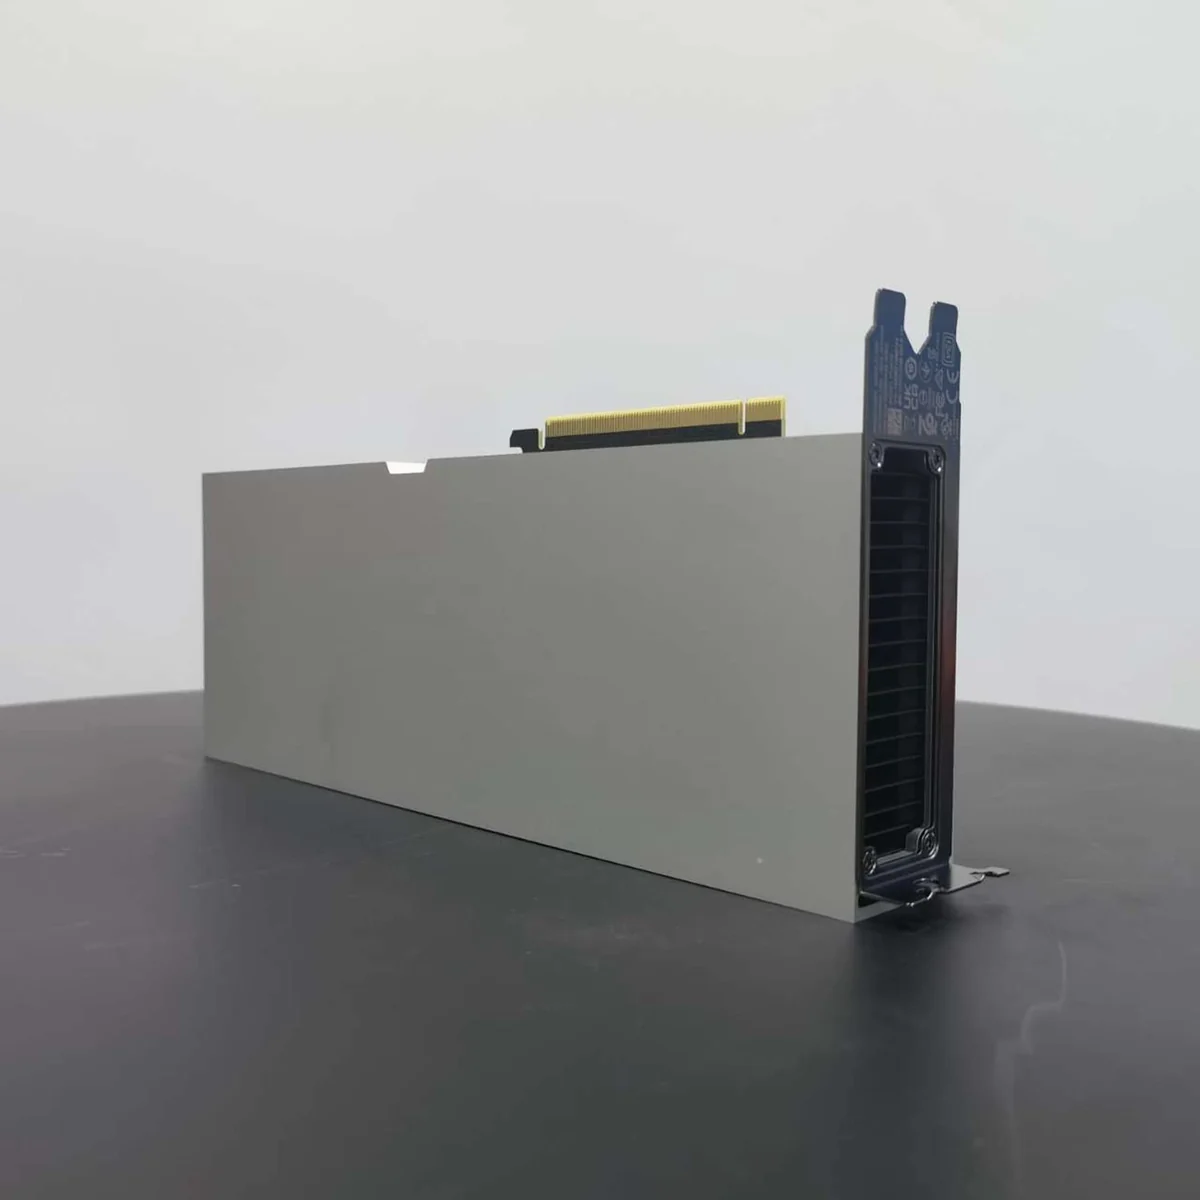
สิ่งที่ทำให้ CMP 170HX แตกต่างจากการ์ดขุดทั่วไปคือแกนหลัก GA100 ซึ่งเป็นตระกูลซิลิคอนเดียวกับ NVIDIA A100 และมีหน่วยความจำ HBM2e อยู่บนแพ็กเกจเดียวกับ GPU จุดเด่นของ HBM2e คือแบนด์วิดท์สูงมาก โดยการทดสอบจากชุมชนในสภาพเดิมวัดได้ราว 1.35 TB/s ขณะที่ข้อมูลของการ์ดระบุค่าสูงสุดใกล้ 1.5 TB/s นี่เป็นคุณสมบัติที่น่าสนใจอย่างยิ่งสำหรับงาน inference ของโมเดลภาษา ซึ่งการอ่านน้ำหนักโมเดลจาก VRAM มักเป็นคอขวดสำคัญ
ปัญหาเดิมคือการ์ดถูกจำกัดทั้งขนาดหน่วยความจำ กำลังคำนวณ และการเชื่อมต่อ PCIe จึงไม่ใช่ตัวเลือกที่ใช้งาน AI ได้เต็มประสิทธิภาพ แม้จะรองรับ CUDA และมี Compute Capability 8.0 ก็ตาม งานวิจัยปี 2025 ที่ทดลอง CMP 170HX ก่อนการปลดล็อกรุ่นใหม่พบว่า FP32 ในโหมดปกติเหลือเพียงประมาณ 0.39 TFLOPS และการหลบข้อจำกัด FMA ในระดับแอปช่วยเพิ่มขึ้นได้ราว 6.2 TFLOPS แต่ยังมีข้อจำกัดกับ Tensor Core และประสิทธิภาพ prefill ของ LLM
สถานการณ์เปลี่ยนไปในปี 2026 เมื่อมีการเผยแพร่งานวิจัย A Canary in the Crypto Mine: Defeating Stack Protection in a GPU Secure Coprocessor และตามมาด้วยโครงการโอเพนซอร์ส cmpunlocker ซึ่งนำเทคนิคดังกล่าวมาทำให้ใช้งานได้สะดวกขึ้น ผลคือ CMP 170HX บางรุ่นสามารถคืนความจุ HBM2e และกำลังคำนวณส่วนที่เคยถูกปิดไว้ จนกลายเป็น GPU สำหรับ Local AI ที่มี VRAM สูงในราคาต่ำกว่าการ์ดศูนย์ข้อมูลระดับ 40–80GB อย่างมาก
2. “ปลดล็อกเฟิร์มแวร์” ที่พูดถึงกัน จริง ๆ แล้วทำงานอย่างไร?
คำว่า “ปลดล็อก Firmware” เป็นคำเรียกที่เข้าใจง่าย แต่ในทางเทคนิค เครื่องมือปัจจุบัน ไม่ใช่แค่การแฟลช VBIOS ใหม่ โครงการ cmpunlocker ระบุว่าใช้แพตช์กับโมดูลเคอร์เนล nvidia-open เพื่อเปิดสิทธิ์และเขียนค่าคอนฟิกที่เกี่ยวข้องกับ SM, HBM2e และ PCIe ก่อนที่ GSP-RM จะเริ่มทำงาน
กล่าวอย่างง่ายคือ ซอฟต์แวร์ไม่ได้สร้างหน่วยความจำเพิ่มขึ้นจากอากาศ แต่พยายามเปิดใช้ทรัพยากรที่มีอยู่จริงบนแพ็กเกจ GA100 ซึ่งถูกปิดหรือซ่อนไว้ด้วยการตั้งค่าระดับเฟิร์มแวร์/OTP
อย่างไรก็ตาม CMP 170HX เป็นชิปที่ผ่านการคัดเกรด (binning) คนละระดับกับ A100 หน่วยความจำหรือส่วนประมวลผลที่ถูกปิดอาจถูกปิดเพราะการแบ่งตลาด หรืออาจมีตำหนิจริงก็ได้ จึงไม่มีหลักประกันว่าการ์ดทุกใบจะปลดล็อกได้เท่ากันหรือเสถียรเท่ากัน
| สิ่งที่ปลดล็อก | ผลที่โครงการรายงาน | ข้อควรรู้ |
|---|---|---|
| กำลังคำนวณของ SM | คืน throughput ของ SS0/SS1 | ผลขึ้นกับเวิร์กโหลดและซอฟต์แวร์ที่ใช้ |
| รุ่นติดป้าย 8GB | มองเห็นประมาณ 64GB | รุ่น Hynix/PCI ID ที่ตรงกันได้รับรายงานว่าเสถียรกว่า แต่ต้องทดสอบรายใบ |
| รุ่นติดป้าย 10GB | โปรไฟล์เสถียรประมาณ 40GB | การเปิด 80GB มีรายงานว่าไม่เสถียรในหลายใบ และอาจต้องลด clock |
| PCIe | เพิ่มจาก Gen 1 เป็น Gen 2 | ยังคงเป็น x4 หากไม่ดัดแปลงฮาร์ดแวร์ |
| BAR1 | เปิดขนาดได้ถึง 64GB ตามโปรไฟล์ | ช่วยให้ระบบเข้าถึงพื้นที่ VRAM ได้เหมาะสมขึ้น |
| ค่าหลังรีบูต | ทำซ้ำผ่านไดรเวอร์ที่แพตช์ | ต้องคงเวอร์ชันไดรเวอร์/เคอร์เนลที่รองรับ |
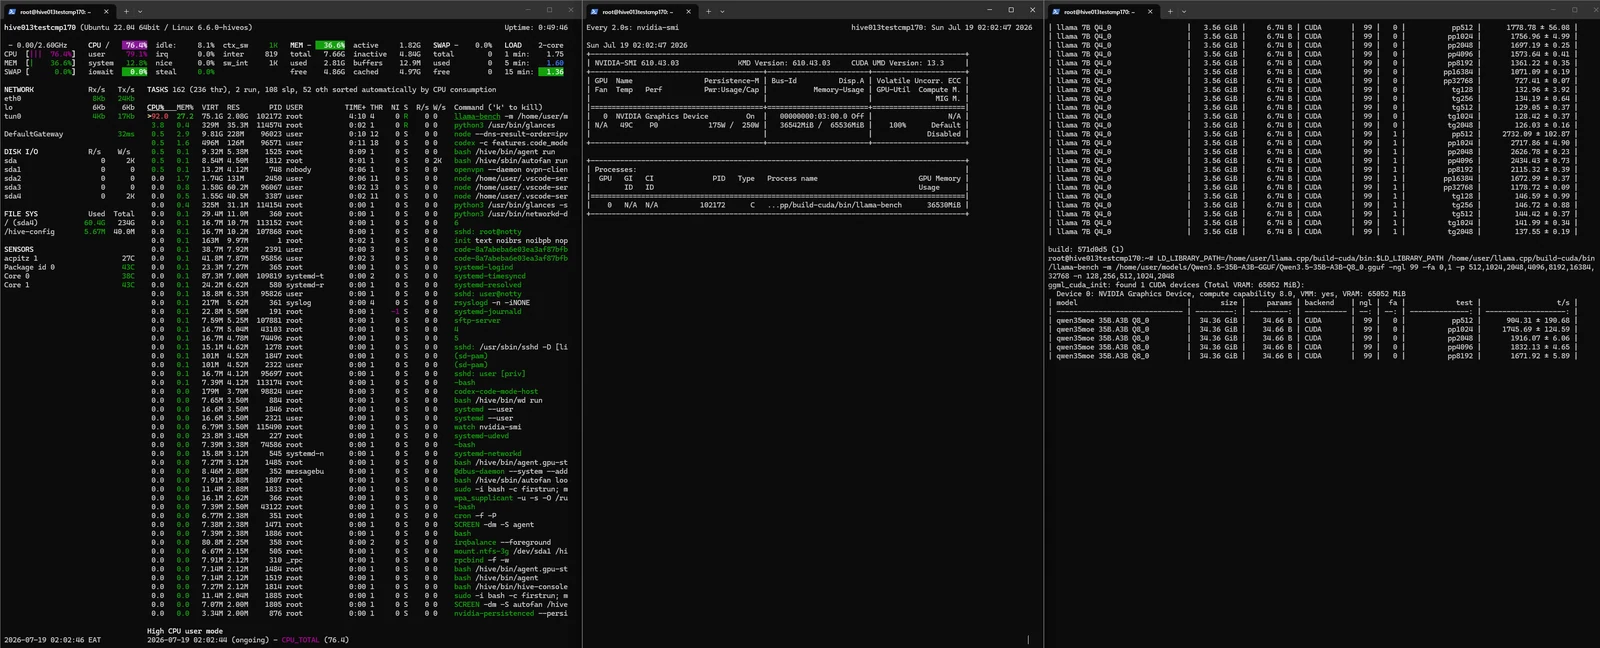
nvidia-smi หลังปลดล็อก CMP 170HX 8GB เป็น 64GB — ตัวเลขนี้เป็นผลของการ์ดและระบบหนึ่งเท่านั้น ไม่ใช่การรับประกันว่าทุกใบจะได้ผลเหมือนกันภาพ: ผู้ใช้จาก กระทู้ r/LocalLLaMA — ใช้เพื่อประกอบการรีวิวเชิงเทคนิค3. สเปก CMP 170HX ที่สำคัญต่อการรัน AI
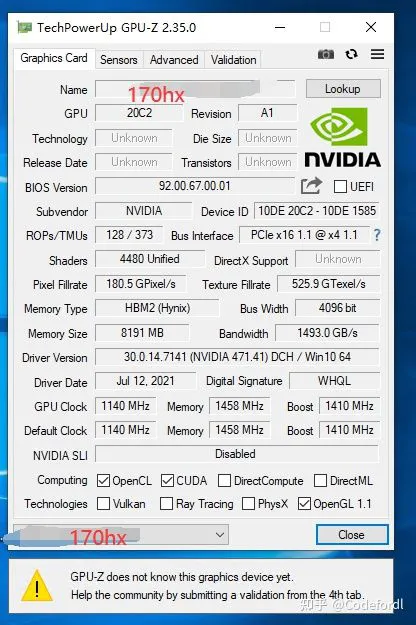
| 項目 | CMP 170HX เดิม | หลังปลดล็อกตามรายงานชุมชน |
|---|---|---|
| สถาปัตยกรรม | NVIDIA Ampere, GA100 | เหมือนเดิม |
| กระบวนการผลิต | 7 นาโนเมตร | เหมือนเดิม |
| SM ที่แสดงในรุ่นทั่วไป | 70 SM | คืน throughput ของ SM ที่มีอยู่ ไม่ได้ทำให้เท่ากับ A100 108 SM |
| CUDA Compute Capability | 8.0 | 8.0 |
| VRAM | 8GB หรือ 10GB HBM2e | 8GB → 64GB; 10GB → 40GB แบบเน้นเสถียรภาพ |
| Memory bus | กว้างสูงสุด 4,096 บิตตามรุ่น | ขึ้นกับ geometry และ stack ที่เปิดใช้ได้จริง |
| Memory bandwidth | เชิงทฤษฎีใกล้ 1.5 TB/s; วัดได้ราว 1.35 TB/s | มีรายงานราว 1.2 TB/s ในระบบใช้งานจริง |
| PCIe | Gen 1 x4 | Gen 2 x4 ผ่านซอฟต์แวร์; x16 ต้องดัดแปลง PCB แยกต่างหาก |
| กำลังไฟ | ประมาณ 250W ตามสเปกการ์ด | อาจปรับ power limit ตามระบบและการระบายความร้อน |
| พอร์ตภาพ | なし | なし |
| ระบบระบายความร้อน | Passive สำหรับลมแรงในเซิร์ฟเวอร์ | ต้องเพิ่ม blower, duct หรือ waterblock เมื่อใช้กับเคสทั่วไป |
| ระบบปฏิบัติการ | ไม่รองรับแบบ plug-and-play | Linux x86-64, root, ปิด Secure Boot และไดรเวอร์เวอร์ชันที่รองรับ |
4. CMP 170HX 64GB ใช้ทำ AI อะไรได้บ้าง?
4.1 รัน Large Language Model ภายในเครื่อง
VRAM 64GB ทำให้การ์ดใบเดียวสามารถเก็บโมเดลแบบ quantized ที่ใหญ่กว่าการ์ดเกม 24–32GB ได้มาก โดยทั่วไปมีโอกาสรองรับโมเดล dense ระดับ 70B ที่ quantization ประมาณ 4-bit รวมทั้ง KV cache และ context ในระดับหนึ่ง ทั้งนี้ขนาดจริงขึ้นกับสถาปัตยกรรมโมเดล รูปแบบ quantization ความยาว context และ backend
| ขนาดโมเดลโดยประมาณ | ขนาดน้ำหนักแบบ 4-bit โดยคร่าว | ความเหมาะสมบน 64GB |
|---|---|---|
| 7B–14B | ประมาณ 4–9GB | เหลือพื้นที่สำหรับ context, batch หรือหลายโมเดลมาก |
| 20B–35B | ประมาณ 12–25GB | เหมาะกับ Local AI และงาน coding assistant |
| 70B | ประมาณ 40–45GB | มีโอกาสวางทั้งโมเดลใน VRAM พร้อมพื้นที่ KV cache แต่ต้องวางแผน context |
| MoE ขนาดใหญ่ | แตกต่างมากตามจำนวนพารามิเตอร์ทั้งหมดและ active parameters | บางรุ่นเหมาะมากเพราะใช้ compute ต่อ token ต่ำ แต่ต้องดูขนาดไฟล์จริง |
ผลทดสอบที่ผู้ใช้เผยแพร่ในชุมชน llama.cpp รายงานว่า CMP 170HX 64GB ใบเดียวบน Ubuntu 24.04 สามารถทำ llama-2-7B Q4_0 ได้ราว 129–141 tokens/s ในช่วงทดสอบ generation ต่าง ๆ และ prefill มากกว่า 1,000 tokens/s ที่ context สูง อย่างไรก็ตาม ตัวเลขนี้เป็นผลจากระบบหนึ่ง ไม่ใช่ค่ารับประกัน และไม่ควรนำไปเทียบข้ามโมเดลหรือข้าม backend โดยตรง
มีรายงานภาคสนามอีกรายที่ใช้การ์ด 8GB ปลดเป็น 64GB จำนวน 4 ใบ ระบุว่าสามารถรันทั้ง LLM และ ComfyUI พร้อมกันบนการ์ดเดียวเมื่อผลรวมการใช้ VRAM ไม่เกิน 64GB พร้อมย้ำว่ารุ่น 8GB ทำงานที่ 64GB ได้ ส่วนรุ่น 10GB ใช้โปรไฟล์ 40GB ที่มีแบนด์วิดท์สูงกว่า
4.2 Stable Diffusion, FLUX และงานสร้างภาพ
VRAM จำนวนมากเป็นประโยชน์ต่อ workflow ที่มีหลายโมเดล เช่น base model, ControlNet, LoRA, VAE, upscaler และ LLM ช่วยเขียน prompt ในเครื่องเดียวกัน ผู้ใช้สามารถเก็บโมเดลหลายชุดใน VRAM ลดการสลับข้อมูลผ่าน PCIe ซึ่งเป็นจุดอ่อนของการ์ดรุ่นนี้ได้
ข้อจำกัดคือซอฟต์แวร์บางตัวอาจตรวจชื่อ GPU หรือพึ่งฟีเจอร์เฉพาะการ์ดรุ่นใหม่ จึงต้องทดสอบ PyTorch, CUDA และแพ็กเกจที่ต้องใช้จริงก่อนนำไปทำงานผลิต
4.3 Embedding, RAG และ AI Agent ภายในองค์กร
ระบบ RAG และ AI Agent สำหรับผู้ใช้ไม่มาก เหมาะกับรูปแบบ “โหลดโมเดลไว้แล้วให้บริการนาน ๆ” เพราะลดผลกระทบจาก PCIe x4 หลังโมเดลอยู่ใน HBM แล้ว งาน embedding, reranking, speech model และ vision model หลายตัวสามารถอยู่ร่วมกันได้หากบริหาร VRAM ดี
4.4 งานที่ต้องการ Memory Bandwidth สูง
HBM2e ทำให้ CMP 170HX น่าสนใจในงานที่ติดคอขวดด้านการอ่านหน่วยความจำ เช่น token generation บางรูปแบบ การคำนวณเชิงวิทยาศาสตร์บางชนิด และ workload แบบ integer-heavy อย่างไรก็ตาม ต้อง benchmark ด้วยโปรแกรมจริง เพราะแบนด์วิดท์สูงไม่ได้ชดเชยข้อจำกัดด้าน compute, Tensor Core, PCIe หรือซอฟต์แวร์ได้ทุกกรณี
5. ประสิทธิภาพ AI: แรงแค่ไหนเมื่อเทียบกับ A100 และการ์ดเกม?
ความเข้าใจผิดที่พบบ่อยคือ “GA100 เหมือนกัน จึงแรงเท่า A100” ความจริง CMP 170HX ที่ปลดล็อกยังมีเพียงประมาณ 70 SM ขณะที่ A100 เต็มรุ่นมีถึง 108 SM และ A100 ยังมีระบบเชื่อมต่อ ฟีเจอร์ศูนย์ข้อมูล ECC, MIG, NVLink และซอฟต์แวร์ที่ผ่านการรับรองครบกว่า
งานวิจัยด้านการปลดล็อกรายงานผลระดับประมาณ 12.2 TFLOPS สำหรับ FP32 SGEMM และประมาณ 94 TFLOPS ในเส้นทาง TF32 Tensor หลังปลดข้อจำกัดในตัวอย่างทดสอบ ขณะที่ผลเก่าที่ใช้วิธีหลบ FMA ระดับแอปอยู่ราว 6.2 TFLOPS ความต่างนี้สะท้อนว่า “วิธีปลดล็อก” และชุดทดสอบมีผลอย่างมาก ไม่ควรหยิบตัวเลขจากคนละยุคมาเทียบกันโดยไม่ระบุบริบท
| ประเด็น | CMP 170HX 64GB ปลดล็อก | NVIDIA A100 | การ์ดเกมระดับสูง 24–32GB |
|---|---|---|---|
| จุดแข็งหลัก | VRAM/HBM ต่อราคาสูง, memory bandwidth สูง | เสถียร รองรับองค์กร compute และ interconnect ครบ | ใช้ง่ายกว่า ไดรเวอร์ปกติ PCIe เร็ว |
| ความจุ | 40–64GB ตามรายงาน | 40GB หรือ 80GB ตามรุ่น | โดยมาก 24–32GB |
| PCIe | Gen 2 x4 หลังปลดซอฟต์แวร์ | Gen 4 x16 ในรุ่น PCIe | โดยทั่วไป Gen 4/5 x16 |
| Display output | なし | ไม่มีในฐานะ accelerator | あり |
| Multi-GPU | ไม่มี NVLink; x4 เป็นคอขวด | NVLink/NVSwitch ตามรุ่น | จำกัด ส่วนใหญ่ไม่มี NVLink |
| ความเสถียร/การรับรอง | ต้องทดสอบเอง ไม่มีการรับรอง unlock จาก NVIDIA | ระดับศูนย์ข้อมูล มี ecosystem และ support | ไดรเวอร์มาตรฐาน ใช้ workstation ง่ายกว่า |
| ผู้ใช้ที่เหมาะ | Homelab/นักพัฒนาที่ดูแล Linux และยอมรับความเสี่ยง | องค์กร วิจัย production | ผู้ใช้ทั่วไป นักสร้างคอนเทนต์ |
กล่าวโดยสรุป CMP 170HX ไม่ใช่ “การ์ดที่เร็วที่สุด” แต่เป็น “การ์ดที่ใส่โมเดลใหญ่ได้ในงบที่อาจต่ำกว่า” คุณค่าหลักอยู่ที่ capacity + bandwidth ไม่ใช่การชนะการ์ดรุ่นใหม่ทุก benchmark
6. ข้อจำกัดสำคัญที่ต้องรู้ก่อนซื้อ
6.1 PCIe x4 คือคอขวดที่มองข้ามไม่ได้
การ์ดเดิมถูกจำกัดที่ PCIe Gen 1 x4 หรือแบนด์วิดท์ใช้งานจริงราว 0.8–1.0GB/s ส่วนการปลด Gen 2 เพิ่มเป็นประมาณ 1.6–2.0GB/s ตามสภาพระบบ ซึ่งยังต่ำกว่าการ์ด PCIe Gen 4 x16 หลายเท่า ผลกระทบเห็นชัดเมื่อโหลดโมเดลขนาดใหญ่ ย้าย tensor ระหว่าง CPU–GPU หรือแบ่งโมเดลข้ามหลายการ์ด
การดัดแปลงเป็น x16 เป็น งานฮาร์ดแวร์แยกต่างหาก ต้องบัดกรีชิ้นส่วนบน PCB และไม่ได้เกิดจาก cmpunlocker เพียงอย่างเดียว หากผู้ขายเขียนว่า “PCIe 2.0 x16” ควรขอภาพ PCB, ผล lspci, link width/link speed ขณะโหลด และหลักฐาน stress test จากการ์ดใบจริง
6.2 64GB ไม่ได้เสถียรทุกใบ
CMP 170HX เป็นผลิตภัณฑ์ที่ผ่านการ binning การเปิด HBM stack ที่ถูกปิดไว้อาจพบ error, ลด clock ไม่ได้ตามที่คาด หรือใช้งานได้เฉพาะบาง geometry รุ่น 8GB ที่ใช้ Hynix และมี PCI ID ตรงกับชุดที่ชุมชนทดสอบถูกมองว่าเป็นตัวเลือกที่น่าสนใจกว่าสำหรับ 64GB ส่วนรุ่น 10GB ที่พยายามเปิด 80GB มีรายงาน error ภายใต้ stress จึงมีโปรไฟล์ 40GB เพื่อความเสถียร
6.3 ECC และฟีเจอร์ศูนย์ข้อมูลไม่เท่ากับ A100
ถึงแม้ HBM จะอยู่บนแพ็กเกจ GA100 แต่ผู้ซื้อไม่ควรสมมติว่า on-die ECC, MIG, NVLink และความสามารถ RAS ทุกอย่างทำงานเหมือน A100 งานที่ความผิดพลาดเงียบแม้เพียงบิตเดียวมีต้นทุนสูง เช่น การฝึกโมเดลระยะยาว งานวิทยาศาสตร์สำคัญ หรือระบบ production หลายผู้ใช้ ควรเลือกฮาร์ดแวร์ที่มีการรับรองมากกว่า
6.4 ต้องใช้ไดรเวอร์ที่แพตช์และปิด Secure Boot
README ของ cmpunlocker ระบุความต้องการเป็น Linux x86-64, สิทธิ์ root, nvidia-open 610.43.0x, kernel headers ที่ตรงกัน และปิด Secure Boot เพราะโมดูลที่แพตช์ไม่มีลายเซ็น นั่นหมายความว่าการอัปเดต kernel หรือ driver โดยไม่ทดสอบอาจทำให้ระบบบูตแล้วมองไม่เห็นการ์ดหรือคืนค่าเป็นสถานะเดิม
6.5 ระบบระบายความร้อนไม่เหมือนการ์ดเกม
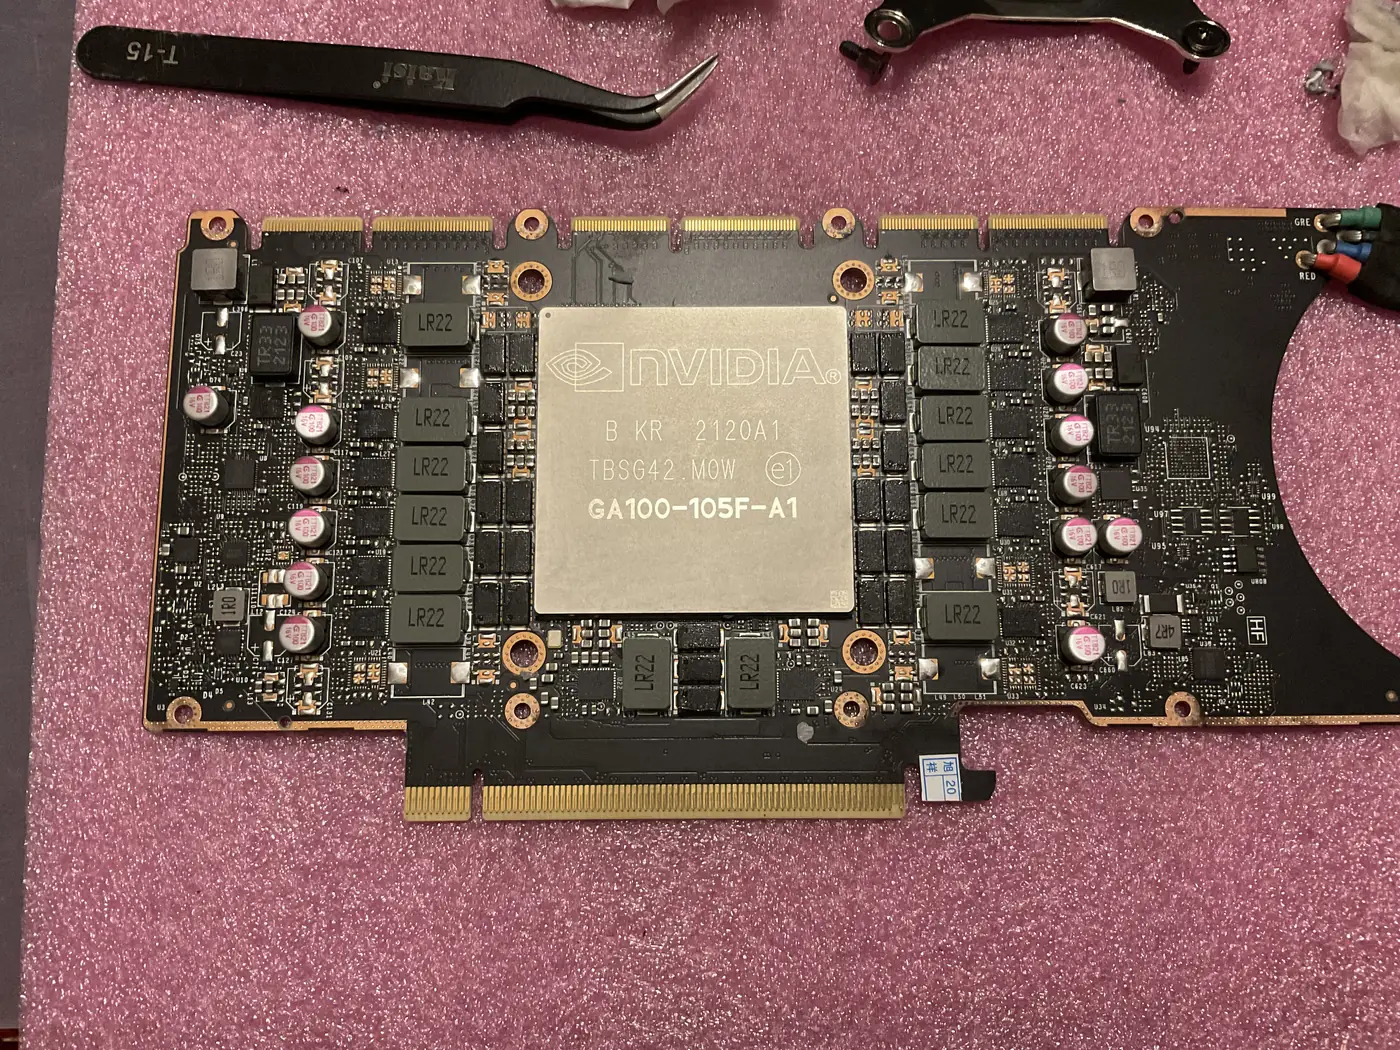
ฮีตซิงก์เดิมเป็นแบบ passive ซึ่งออกแบบให้ลมแรงจากพัดลมหน้าเซิร์ฟเวอร์พัดผ่านตลอด การติดตั้งในเคสพีซีทั่วไปโดยไม่มี fan duct อาจทำให้อุณหภูมิสูงและ throttle ได้ ผู้ใช้อาจต้องเพิ่ม blower, พิมพ์ shroud, ใช้เคสเซิร์ฟเวอร์ หรือเปลี่ยนเป็น waterblock ที่เข้ากับ PCB ตระกูล A100 40GB/CMP 170HX โดยต้องตรวจรุ่นให้ถูกต้อง
6.6 ไม่มีพอร์ตภาพและไม่เหมาะกับเกม
CMP 170HX เป็น compute accelerator แบบ headless ไม่มี HDMI หรือ DisplayPort การติดตั้งระบบควรใช้ iGPU หรือการ์ดอีกใบสำหรับแสดงผล และไม่ควรซื้อเพื่อใช้แทน GeForce สำหรับเล่นเกมหรือทำงานกราฟิกทั่วไป
7. ราคา CMP 170HX ในปี 2026: ยังเรียกว่า “ถูก” ได้หรือไม่?
คำว่า “ราคาถูก” ต้องมีตัวเปรียบเทียบ ช่วงก่อนข่าวปลดล็อก แหล่งข่าวรายงานว่าการ์ดบางใบเคยขายเพียงประมาณ 100–300 ดอลลาร์สหรัฐ แต่หลังชุมชนเผยเครื่องมือและผลทดสอบ 64GB ราคามือสองเพิ่มขึ้นอย่างรวดเร็ว
จากหน้ารวมประกาศ eBay ที่ตรวจเมื่อวันที่ 23 สิงหาคม 2026 พบราคาตั้งขายจำนวนมากประมาณ 1,400–2,200 ดอลลาร์ ขึ้นกับรุ่น สภาพ การยืนยัน unlock และการดัดแปลง PCIe ขณะที่ประกาศ Alibaba สำหรับรุ่นปลดเป็น 64GB อยู่ราว 1,464–1,664 ดอลลาร์ อัตรากลาง USD/THB วันเดียวกันอยู่ใกล้ 32.67 บาทต่อดอลลาร์ จึงคิดเป็นราว 46,000–72,000 บาท ก่อนภาษี ค่าขนส่ง อะแดปเตอร์ไฟ การระบายความร้อน และความเสี่ยงจากสินค้ามือสอง
| ต้นทุนที่ต้องเผื่อ | เหตุผล |
|---|---|
| ตัวการ์ดมือสอง | ราคาเปลี่ยนเร็วและมีการเก็งกำไรหลังข่าว unlock |
| สายไฟ/อะแดปเตอร์ที่ถูกต้อง | การ์ดเซิร์ฟเวอร์บางใบใช้ขั้วไฟที่หน้าตาคล้าย PCIe แต่ pinout ต้องตรวจให้แน่ชัด |
| Blower, shroud หรือ waterblock | ฮีตซิงก์เดิมต้องใช้ airflow สูง |
| PSU คุณภาพสูง | การ์ดประมาณ 250W และระบบหลายใบกินไฟมาก |
| เมนบอร์ดและ riser | ต้องรองรับ PCIe bifurcation หากติดหลายใบ |
| SSD/NVMe | ช่วยลดเวลารอโหลดโมเดล แม้ PCIe ของการ์ดยังเป็นคอขวด |
| ค่าแรงและเวลาทดสอบ | ต้อง stress test VRAM, CUDA, อุณหภูมิ และ workload จริง |
| ความเสี่ยงไม่มีประกัน | การ์ดขุดมือสองอาจผ่านงานหนักมาแล้ว และการปลดล็อกไม่ใช่บริการจาก NVIDIA |
ดังนั้น CMP 170HX ยังอาจ “คุ้ม” เมื่อเปรียบเทียบกับ GPU ศูนย์ข้อมูล NVIDIA ที่มี VRAM 64–80GB แต่ไม่ได้ถูกแบบเดิมหลังตลาดรับรู้ข่าว หากราคาตัวการ์ดรวมระบบเข้าใกล้การ์ด workstation มือสองที่ไดรเวอร์ปกติ PCIe x16 และมีประกัน ทางเลือกหลังอาจเหมาะกับธุรกิจมากกว่า

ปรึกษาทีมงานได้ก่อนตัดสินใจ เราช่วยตรวจสเปกจากใบจริง เทียบรุ่นที่เหมาะกับงบประมาณ และสอบถามสินค้าหรือสั่งซื้อได้ทาง LINE ไม่มีค่าใช้จ่ายในการปรึกษา
8. เช็กลิสต์ก่อนซื้อ CMP 170HX เพื่อรัน Local AI
- ขอ PCI Device ID จากใบจริง — ชุมชนแนะนำให้ยืนยัน
10de:20c2สำหรับรุ่น 8GB ที่ต้องการปลดเป็น 64GB และอย่าเชื่อเพียงชื่อบนประกาศ - ขอภาพ
nvidia-smiหลัง cold boot — ต้องเห็นความจุรวม อุณหภูมิ power limit และ UUID/Bus ID ของใบที่จะส่งจริง - ขอผล stress test ครบพื้นที่ VRAM — การเห็น 64GB ไม่ได้แปลว่าอ่าน–เขียนครบ 64GB โดยไม่มี error
- ตรวจชนิด HBM และรุ่น 8GB/10GB — โปรไฟล์การปลดและความเสถียรไม่เหมือนกัน
- ยืนยัน PCIe link speed และ width — แยกให้ชัดระหว่าง Gen 2 ที่ปลดด้วยซอฟต์แวร์กับ x16 ที่ดัดแปลงฮาร์ดแวร์
- ขออุณหภูมิภายใต้โหลดอย่างน้อย 30–60 นาที — พร้อมภาพระบบพัดลมหรือ waterblock ที่ใช้ทดสอบ
- ตรวจขั้วไฟและสายแปลง — ห้ามเสียบสายตามรูปร่างโดยไม่ยืนยัน pinout และคู่มือของบอร์ด
- ขอเงื่อนไขคืนสินค้า — ระบุกรณี unlock ไม่ได้, VRAM error, CUDA error หรือ link width ไม่ตรงประกาศ
- ตรวจ repository และ driver version — อย่ารับไฟล์ binary ไม่ทราบที่มาเพียงเพราะผู้ขายบอกว่า “พร้อมใช้ AI”
- ทดสอบด้วยโมเดลจริงก่อนซื้อหลายใบ — เริ่มหนึ่งใบ วัด tokens/s, prefill, เวลาโหลด, กำลังไฟ และ uptime ก่อนขยายระบบ
9. วิธีประเมินความคุ้มค่าที่ถูกต้อง
อย่าดูเฉพาะ “บาทต่อ GB VRAM” ควรคิดต้นทุนรวมเป็น บาทต่อผลงานที่ทำได้อย่างเสถียร ด้วยสูตรง่าย ๆ ดังนี้
ต้นทุนรวมระบบ = ราคาการ์ด
              + ค่าระบายความร้อน
              + PSU / เมนบอร์ด / เคส
              + ภาษีและขนส่ง
              + ค่าแรงดูแล
              + ต้นทุน downtime
จากนั้น benchmark อย่างน้อย 5 ค่า
- 📦ขนาดโมเดลและ quantization ที่ต้องการใช้จริง
- ⚡Prompt processing หรือ prefill tokens/s
- ✍️Text generation tokens/s
- ⏱️เวลาโหลดโมเดลและเวลาย้ายข้อมูลผ่าน PCIe
- 🌡️กำลังไฟ อุณหภูมิ และ error หลังรันต่อเนื่อง 24–72 ชั่วโมง
หากเป้าหมายคือแชตบอตภายในบริษัทหนึ่งถึงไม่กี่ผู้ใช้ที่โหลดโมเดลไว้ตลอด CMP 170HX อาจให้ความคุ้มค่าดี แต่หากต้องสลับโมเดลบ่อย ให้บริการ concurrent สูง ฝึกโมเดลหลายวัน หรือแบ่งงานข้าม GPU จำนวนมาก PCIe x4, การไม่มี NVLink และความเสี่ยงเรื่องเสถียรภาพอาจทำให้ต้นทุนจริงสูงขึ้น
10. CMP 170HX เหมาะกับใคร?
✅ เหมาะกับ
- 🧑💻นักพัฒนา Local AI, Homelab และห้องวิจัยที่ดูแล Linux ได้
- 💾ผู้ที่ต้องการ VRAM 40–64GB เพื่อใส่โมเดลใหญ่ใน GPU ใบเดียว
- 🔁งาน inference แบบโหลดโมเดลค้างไว้ ลดการย้ายข้อมูลผ่าน PCIe
- 📌ผู้ที่ยอมรับการ pin เวอร์ชัน driver และทดสอบฮาร์ดแวร์เอง
- 🏭ผู้ซื้อที่ได้การ์ดในราคาต่ำและมีระบบเซิร์ฟเวอร์/ระบายความร้อนอยู่แล้ว
❌ ไม่เหมาะกับ
- 🏢ระบบ production ที่ต้องการ SLA, ECC, vendor support และ downtime ต่ำ
- 🪟ผู้ใช้ Windows ที่ต้องการเสียบแล้วใช้งานทันที
- 🎮เกม งานตัดต่อ หรือกราฟิกที่ต้องใช้พอร์ตแสดงผลและ video engine
- 🔗งาน multi-GPU ที่ย้าย tensor ระหว่างการ์ดอย่างหนัก
- 🧰ผู้ที่ไม่สะดวกตรวจโค้ด kernel, ปิด Secure Boot หรือแก้ปัญหา driver
- 🚀ผู้ซื้อที่คาดหวังประสิทธิภาพเท่า A100/H100 เพียงเพราะมี GA100 และ VRAM สูง
11. บทสรุป: “ของคุ้ม” หรือ “กับดักของถูก”?
CMP 170HX คือหนึ่งในโครงการคืนชีพฮาร์ดแวร์ที่น่าสนใจที่สุดของวงการ Local AI ปี 2026 การปลดล็อกผ่านไดรเวอร์ทำให้การ์ดขุดที่เคยถูกจำกัดสามารถใช้ HBM2e ได้มากถึง 64GB ในรุ่นที่เหมาะสม พร้อมคืนกำลังคำนวณและเพิ่ม PCIe เป็น Gen 2 จุดแข็งนี้ทำให้โมเดลระดับ 70B แบบ quantized มีโอกาสอยู่ใน GPU ใบเดียวได้ โดยไม่ต้องจ่ายราคาแบบ A100 80GB
แต่คำตอบว่า “คุ้มหรือไม่” ขึ้นกับราคาซื้อและความสามารถในการดูแลระบบ ปัจจุบันราคาตลาดเพิ่มขึ้นจากช่วงก่อนข่าวหลายเท่า และผู้ใช้ยังต้องรับความเสี่ยงจากการ์ดมือสอง ความเสถียรของ HBM ไดรเวอร์ที่แพตช์ PCIe x4 ระบบระบายความร้อน และการไม่มีการรับรองจาก NVIDIA
12. คำถามที่พบบ่อยเกี่ยวกับ CMP 170HX และการปลดล็อก 64GB
CMP 170HX คือการ์ดจอสำหรับ AI หรือไม่?
เดิมเป็น Cryptocurrency Mining Processor ไม่มีพอร์ตแสดงผล แต่ใช้ชิปตระกูล GA100 และรองรับ CUDA จึงสามารถนำมาทำ compute/AI ได้หลังชุมชนพัฒนาเครื่องมือคืนข้อจำกัดบางส่วน อย่างไรก็ตามไม่ใช่ผลิตภัณฑ์ AI ที่ NVIDIA รับรองให้ใช้งานในรูปแบบนี้
CMP 170HX 8GB ปลดเป็น 64GB ได้ทุกใบหรือไม่?
ไม่ได้รับประกันทุกใบ ผลขึ้นกับ PCI ID, รุ่นบอร์ด, HBM, การ binning และสภาพการ์ด ต้องตรวจความจุหลัง cold boot และ stress test ครบพื้นที่หน่วยความจำก่อนใช้งานจริง
รุ่น 10GB ปลดเป็น 80GB ได้หรือไม่?
มีรายงานว่าสามารถมองเห็น 80GB ได้ แต่หลายใบไม่เสถียรที่ความเร็วเต็ม โครงการ cmpunlocker จึงให้โปรไฟล์ 10GB → 40GB เป็นค่าที่เน้นใช้งานจริงมากกว่า อย่าซื้อจากคำโฆษณา “80GB” โดยไม่มีผล stress test
การปลดล็อกต้องแฟลช BIOS หรือบัดกรีหรือไม่?
การปลด VRAM, compute และ PCIe Gen 2 ของ cmpunlocker เป็นซอฟต์แวร์ผ่านไดรเวอร์ที่แพตช์ ส่วนการเพิ่ม link width จาก x4 เป็น x16 เป็นการดัดแปลงฮาร์ดแวร์แยกต่างหากและมีความเสี่ยงสูงกว่า
ใช้บน Windows ได้หรือไม่?
เครื่องมือหลักปัจจุบันระบุ Linux x86-64 และ nvidia-open เวอร์ชันที่รองรับ ไม่ใช่โซลูชัน plug-and-play สำหรับ Windows ผู้ใช้ควรวางแผนให้เครื่องเป็น Linux compute node
CMP 170HX เล่นเกมได้หรือไม่?
ไม่เหมาะ ไม่มีพอร์ตภาพและถูกออกแบบเป็น accelerator สำหรับงานขุด/compute แม้ระบบจะมองเห็น CUDA ได้ก็ไม่ได้แปลว่าจะให้ประสบการณ์เหมือน GeForce
CMP 170HX 64GB รันโมเดล 70B ได้หรือไม่?
โมเดล 70B แบบ 4-bit โดยมากมีน้ำหนักราว 40–45GB จึงมีโอกาสใส่ใน 64GB ได้ แต่ต้องเผื่อ KV cache, context, workspace และ overhead ของ backend ประสิทธิภาพขึ้นกับโมเดลและซอฟต์แวร์
PCIe x4 ทำให้ AI ช้ามากหรือไม่?
มีผลมากตอนโหลดโมเดล ย้ายข้อมูล CPU–GPU และทำ multi-GPU แต่มีผลน้อยลงเมื่อโมเดลอยู่ใน HBM แล้วและงานเป็น generation แบบใช้การ์ดใบเดียว จึงเหมาะกับการโหลดโมเดลค้างไว้มากกว่าสลับโมเดลตลอดเวลา
CMP 170HX ใช้ไฟเท่าไร?
สเปกอ้างอิงอยู่ประมาณ 250W แต่การใช้จริงขึ้นกับ power limit, clock และ workload ต้องเผื่อ PSU คุณภาพสูงและ airflow สำหรับระบบหลายใบ พร้อมวัดกำลังไฟที่เต้ารับจริง
ควรซื้อ CMP 170HX ตอนนี้หรือไม่?
ควรซื้อเมื่อยืนยันรุ่นและผลปลดล็อกจากใบจริง มีสิทธิ์คืนสินค้า ราคา total system ยังต่ำกว่าทางเลือกที่รองรับอย่างเป็นทางการ และคุณยอมรับการดูแล Linux/driver เอง หากเงื่อนไขเหล่านี้ไม่ครบ ควรเปรียบเทียบกับ GPU workstation หรือ data center มือสองก่อน
参考文献
ข้อมูลตรวจสอบล่าสุดวันที่ 23 สิงหาคม 2026 ราคาและสถานะซอฟต์แวร์อาจเปลี่ยนได้ ควรตรวจ repository และประกาศขายอีกครั้งก่อนตัดสินใจ
- cmpunlocker — โครงการปลดล็อกหลักบน GitHub
- คู่มือชุมชนสำหรับ patched nvidia-open 610.43.03
- A Canary in the Crypto Mine: Defeating Stack Protection in a GPU Secure Coprocessor
- Exploration of Cryptocurrency Mining-Specific GPUs in AI Applications — arXiv
- NVIDIA Ampere Architecture In-Depth — ข้อมูล GA100/A100 อย่างเป็นทางการ
- NVIDIA A100 Tensor Core GPU — หน้าผลิตภัณฑ์อย่างเป็นทางการ
- All GB/s without FLOPS — รีวิวและผลทดสอบ CMP 170HX ก่อน unlock รุ่นใหม่
- llama.cpp discussion — ผลทดสอบ CMP 170HX 64GB จากผู้ใช้
- I tested the CMP170HX — ผลทดสอบหลายโมเดลจากผู้ใช้ r/LocalLLaMA
- Tom’s Hardware — รายงานข่าวการปลดล็อกและความเสี่ยงของ HBM