
อัปเดต 23 สิงหาคม 2026
บทความนี้สรุปคำศัพท์หลักของหุ่นยนต์ AI ยุคใหม่ในระดับแนวคิดและสถาปัตยกรรม เหมาะสำหรับนักศึกษาวิศวกรรม นักพัฒนา และผู้ที่ต้องประเมินเทคโนโลยีหุ่นยนต์
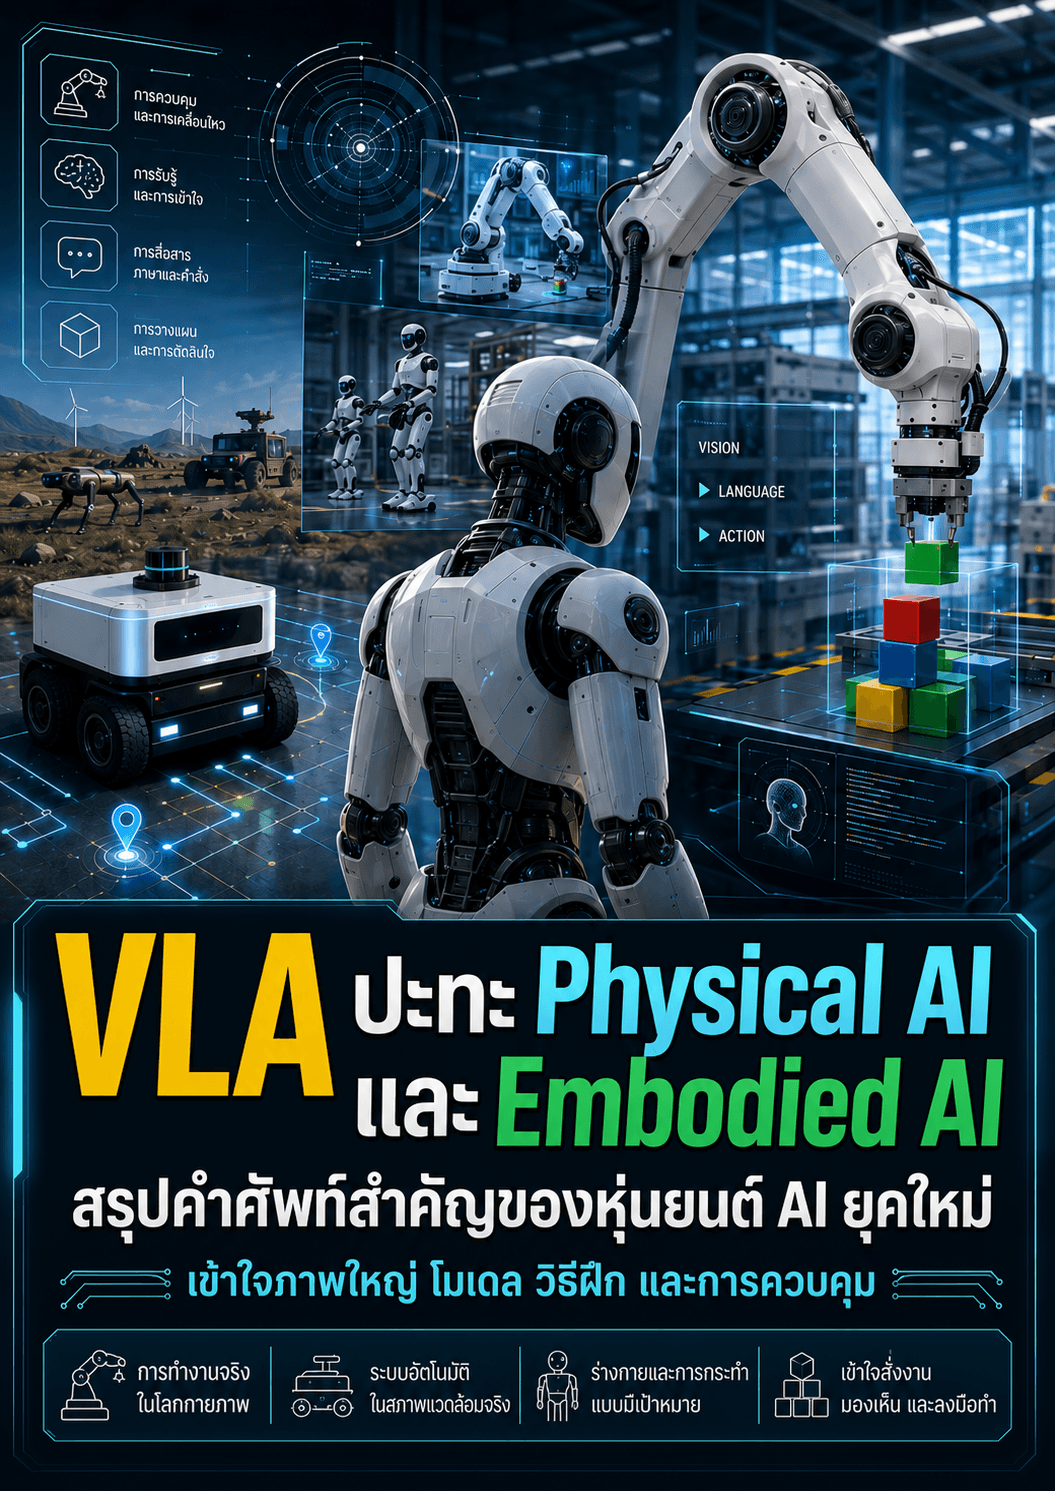
ถ้าคุณกำลังอ่านข่าวหุ่นยนต์ฮิวแมนนอยด์หรือ AI ในช่วงนี้ คุณจะเจอคำว่า Physical AI, Embodied AI 以及 VLA (Vision-Language-Action) ปะปนกันจนแยกไม่ออกว่าอันไหนคืออะไร ปัญหาคือคำเหล่านี้ ไม่ได้อยู่ในระดับเดียวกัน การเอามาเทียบตรง ๆ จึงทำให้สับสน บทความนี้จะจัดวางทุกคำลงใน Stack เดียวกัน พร้อมตารางเปรียบเทียบและตัวอย่างการทำงานจริงแบบ End-to-End
🎯 สรุปสั้นที่สุด ก่อนเข้าเนื้อหา
1. ทำไมคำเหล่านี้ถึงมักถูกสับสน?
คำว่า Physical AI, Embodied AI และ VLA ไม่ได้อยู่ในระดับเดียวกัน แต่ละคำอยู่คนละชั้นของระบบ:
- 🌐Physical AI — แนวคิดหรือ Ecosystem ขนาดใหญ่
- 🤖Embodied AI — แนวคิดด้าน Intelligence ที่เชื่อม AI เข้ากับร่างกายและสภาพแวดล้อม
- 🧠VLA — ประเภทของโมเดลที่ใช้เป็น “สมองส่วนหนึ่ง” ของหุ่นยนต์
- 📚Imitation Learning / Reinforcement Learning — วิธีฝึกโมเดล
- 🕹️Simulation / Digital Twin — สนามฝึก
- ⚙️Controller / Motor / Joint — ส่วนที่ทำให้คำสั่งกลายเป็นการเคลื่อนไหวจริง
2. มองเป็น Stack จะเข้าใจง่ายที่สุด
PHYSICAL AI
    │
    ├── Embodied AI / Autonomous Agent
    │       │
    │       ├── Perception
    │       │     ├── Camera
    │       │     ├── LiDAR
    │       │     └── Force / Tactile Sensor
    │       │
    │       ├── Intelligence
    │       │     ├── LLM
    │       │     ├── VLM
    │       │     ├── VLA          ← โมเดลที่บทความนี้เน้น
    │       │     ├── World Model
    │       │     └── Planner
    │       │
    │       └── Action
    │             ├── Robot Policy
    │             ├── Controller
    │             ├── Joint / Motor
    │             └── Gripper / Hand / Wheel
    │
    └── REAL WORLD
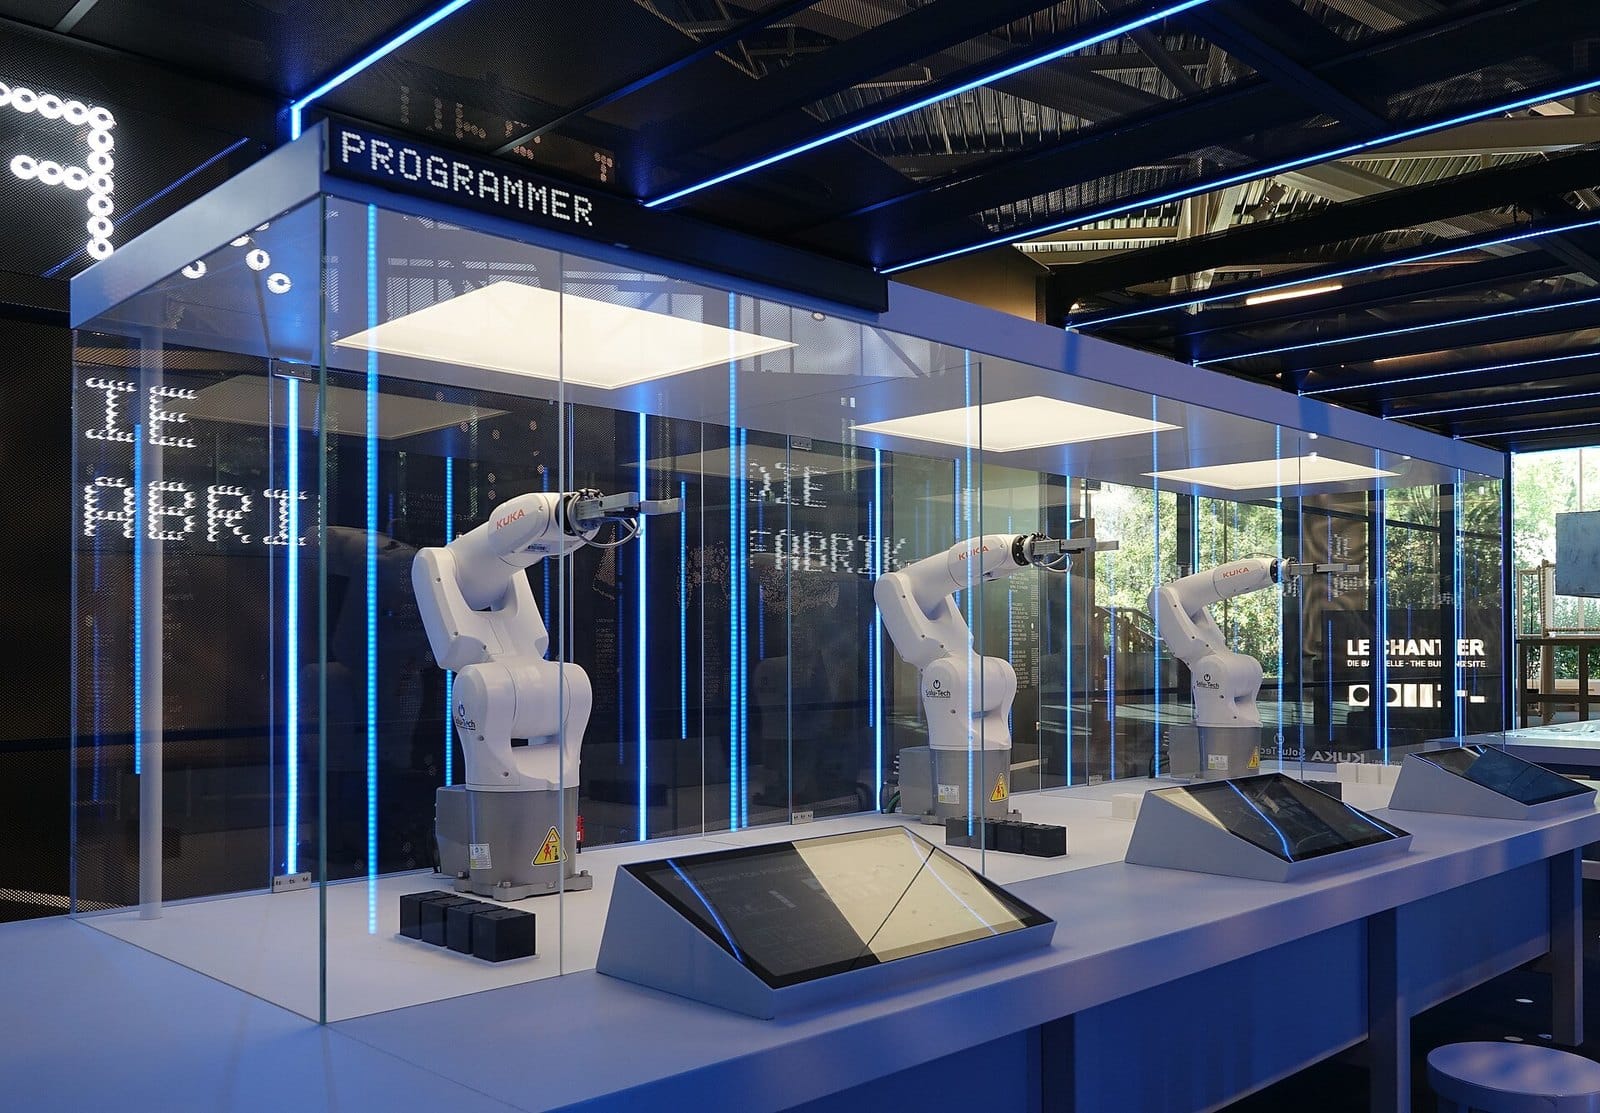
ภาพนี้เหมาะกับ Physical AI เพราะแสดงให้เห็นแขนกลที่ต้องทำงานร่วมกับเครื่องจักรและสภาพแวดล้อมจริง ไม่ใช่แค่ประมวลผลข้อมูลอยู่ในคอมพิวเตอร์
3. ตารางเปรียบเทียบคำศัพท์สำคัญ 21 คำ
| คำศัพท์ | อยู่ระดับไหน | ความหมาย | จำง่าย ๆ | ตัวอย่าง |
|---|---|---|---|---|
| Physical AI | แนวคิดใหญ่ / Ecosystem | AI ที่รับรู้ ตัดสินใจ และกระทำในโลกกายภาพ | AI ออกจากจอมาอยู่ในโลกจริง | Humanoid, AMR, Drone, Robotaxi |
| Embodied AI | Agent / Intelligence | AI ที่มีร่างกายและเรียนรู้ผ่าน Sensor + Action + Environment | AI ที่มีตา มีตัว มีมือเท้า | Humanoid, Robot Arm, Mobile Robot |
| Embodied Intelligence | แนวคิดด้าน Intelligence | ความฉลาดที่เกิดจาก Brain + Body + Environment ร่วมกัน | ร่างกายก็เป็นส่วนหนึ่งของความฉลาด | การจับวัตถุโดยปรับแรงตามสัมผัส |
| VLA | Model / Robot Policy | Vision + Language → Action | เห็น + เข้าใจคำสั่ง + ลงมือทำ | หุ่นหยิบของตามคำสั่งภาษา |
| VLM | Model | Vision + Language | มองเห็นและอธิบายได้ | วิเคราะห์วัตถุในภาพ |
| LLM | Model | Language + Reasoning | คิด วางแผน และสื่อสาร | Task planning |
| Robot Foundation Model | Foundation Model | โมเดลพื้นฐานขนาดใหญ่สำหรับหลายงานหุ่นยนต์ | สมองพื้นฐานของ Robot หลายงาน | General-purpose robot model |
| World Model | Predictive Model | ทำนายว่าโลกจะเปลี่ยนอย่างไรเมื่อเกิด Action | ถ้าทำแบบนี้ ต่อไปจะเกิดอะไร? | Predict object motion |
| Robot Policy | Action Model | Observation / State → Action | ตอนนี้หุ่นควรทำอะไร? | Joint action generation |
| Planner | Planning | วางลำดับ Task หรือเส้นทาง | ทำอะไรก่อน–หลัง | Walk → Reach → Grasp |
| Controller | Low-level Control | ควบคุม Position / Velocity / Torque | สั่งกล้ามเนื้อของหุ่น | PID / MPC / Joint controller |
| Imitation Learning | วิธีฝึก | เรียนจากการสาธิตของมนุษย์ | คนทำให้ดู แล้วหุ่นเรียนตาม | Teleoperation data |
| Behavior Cloning | วิธีฝึก | เรียน Mapping จาก Observation → Action จาก Dataset | เลียนแบบพฤติกรรมจากข้อมูล | Robot manipulation |
| Reinforcement Learning | วิธีฝึก | เรียนจาก Reward / Penalty | ลองเองแล้วเก็บคะแนน | เดิน วิ่ง ทรงตัว |
| Simulation | Training Environment | โลกจำลองสำหรับฝึกและทดสอบ | สนามซ้อมในคอม | Isaac Sim / MuJoCo |
| Sim-to-Real | Deployment Method | ฝึกใน Simulation แล้วนำไปใช้กับ Hardware จริง | ซ้อมเสมือน → ใช้จริง | Policy transfer |
| Digital Twin | Virtual Representation | แบบจำลองดิจิทัลของ Robot / Factory / Environment | ฝาแฝดดิจิทัลของของจริง | Smart factory |
| Synthetic Data | Training Data | ข้อมูลที่สร้างขึ้นจาก Simulation หรือ Generative AI | ข้อมูลฝึกที่สร้างขึ้นเอง | Synthetic camera images |
| Teleoperation | Data Collection / Control | มนุษย์ควบคุม Robot จากระยะไกล | คนยังเป็นสมองให้หุ่น | VR / Master arm |
| Manipulation | Robot Capability | การหยิบ จับ ดัน เปิด หมุน และจัดการวัตถุ | การใช้มือของหุ่น | Robot arm |
| Locomotion | Robot Capability | การเดิน วิ่ง คลาน กระโดด หรือเคลื่อนที่ | การใช้ขา/ฐานเคลื่อนที่ | Humanoid / Quadruped |
4. Physical AI คืออะไร?
Physical AI คือภาพรวมของระบบ AI ที่ต้องทำงานกับ โลกกายภาพจริง ระบบจึงต้องเข้าใจมากกว่า Text หรือ Image เพราะโลกจริงมีเรื่อง แรง น้ำหนัก การเสียดสี ระยะทาง ความเร็ว การชน ความไม่แน่นอน ความปลอดภัย เวลาแบบ Real-time และข้อจำกัดของ Hardware
ดังนั้น Physical AI มักรวมเทคโนโลยีหลายด้านเข้าด้วยกัน:
AI / ML  +  Computer Vision  +  Robotics  +  Control
  +  Sensors  +  Simulation  +  Physics  +  Embedded / Edge Computing
5. Embodied AI คืออะไร?
Embodied AI เน้นแนวคิดว่า AI ไม่ได้มีแค่ “สมอง” แต่มี Body + Sensors + Environment วงจรพื้นฐานคือ:
PERCEIVE → UNDERSTAND → REASON → PLAN → ACT
   → OBSERVE RESULT → ADAPT / RE-PLAN
   └──────────────→ กลับไป PERCEIVE
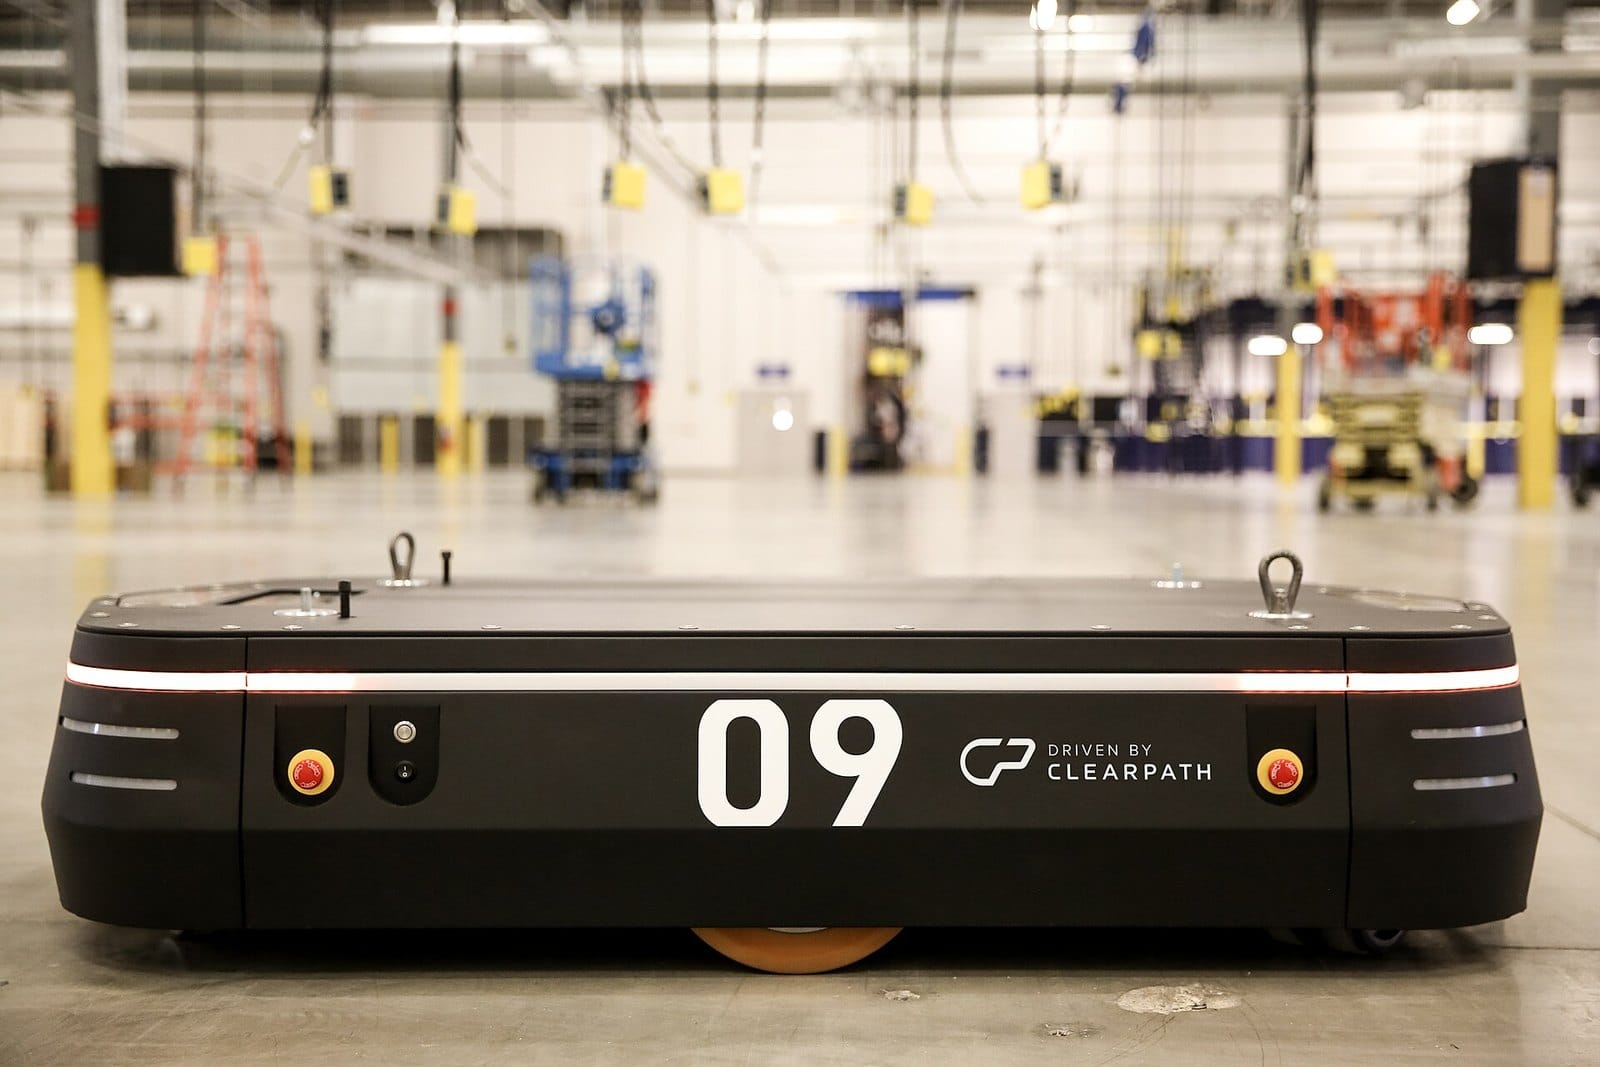
Mobile Robot เป็นตัวอย่างที่เข้าใจง่าย เพราะการ “ฉลาด” ของมันเกิดจากการรวม Camera / LiDAR + Localization + Mapping + Planning + Controller + Motor เข้าด้วยกัน ถ้าขาดส่วนใดส่วนหนึ่ง Robot อาจรู้ว่า “ต้องไปไหน” แต่ไปไม่ได้ หรือเคลื่อนที่ได้แต่ไม่รู้ว่าตัวเองอยู่ที่ไหน
6. VLA คืออะไร? (Vision-Language-Action)
VLA เป็นโมเดลที่เชื่อม 3 โลกเข้าด้วยกัน คือสิ่งที่หุ่นยนต์เห็น (Vision) สิ่งที่มนุษย์สั่ง (Language) และสิ่งที่หุ่นยนต์ต้องทำ (Action)
VISION  (สิ่งที่ Robot เห็น)
   +
LANGUAGE  (สิ่งที่มนุษย์สั่ง)
   ↓
 MODEL
   ↓
ACTION  (สิ่งที่ Robot ต้องทำ)
คำสั่งตัวอย่าง: “หยิบก้อนสีเขียวแล้ววางบนก้อนสีน้ำเงิน”
หุ่นยนต์ต้องทำตามลำดับนี้:
- มองเห็นก้อนทั้งหมด
- แยกสีและตำแหน่ง
- เข้าใจภาษา
- ระบุ Object เป้าหมาย
- เลือกวิธีเข้าหาวัตถุ
- สร้าง Action
- ควบคุมแขนและ Gripper
- ตรวจว่าทำสำเร็จหรือไม่
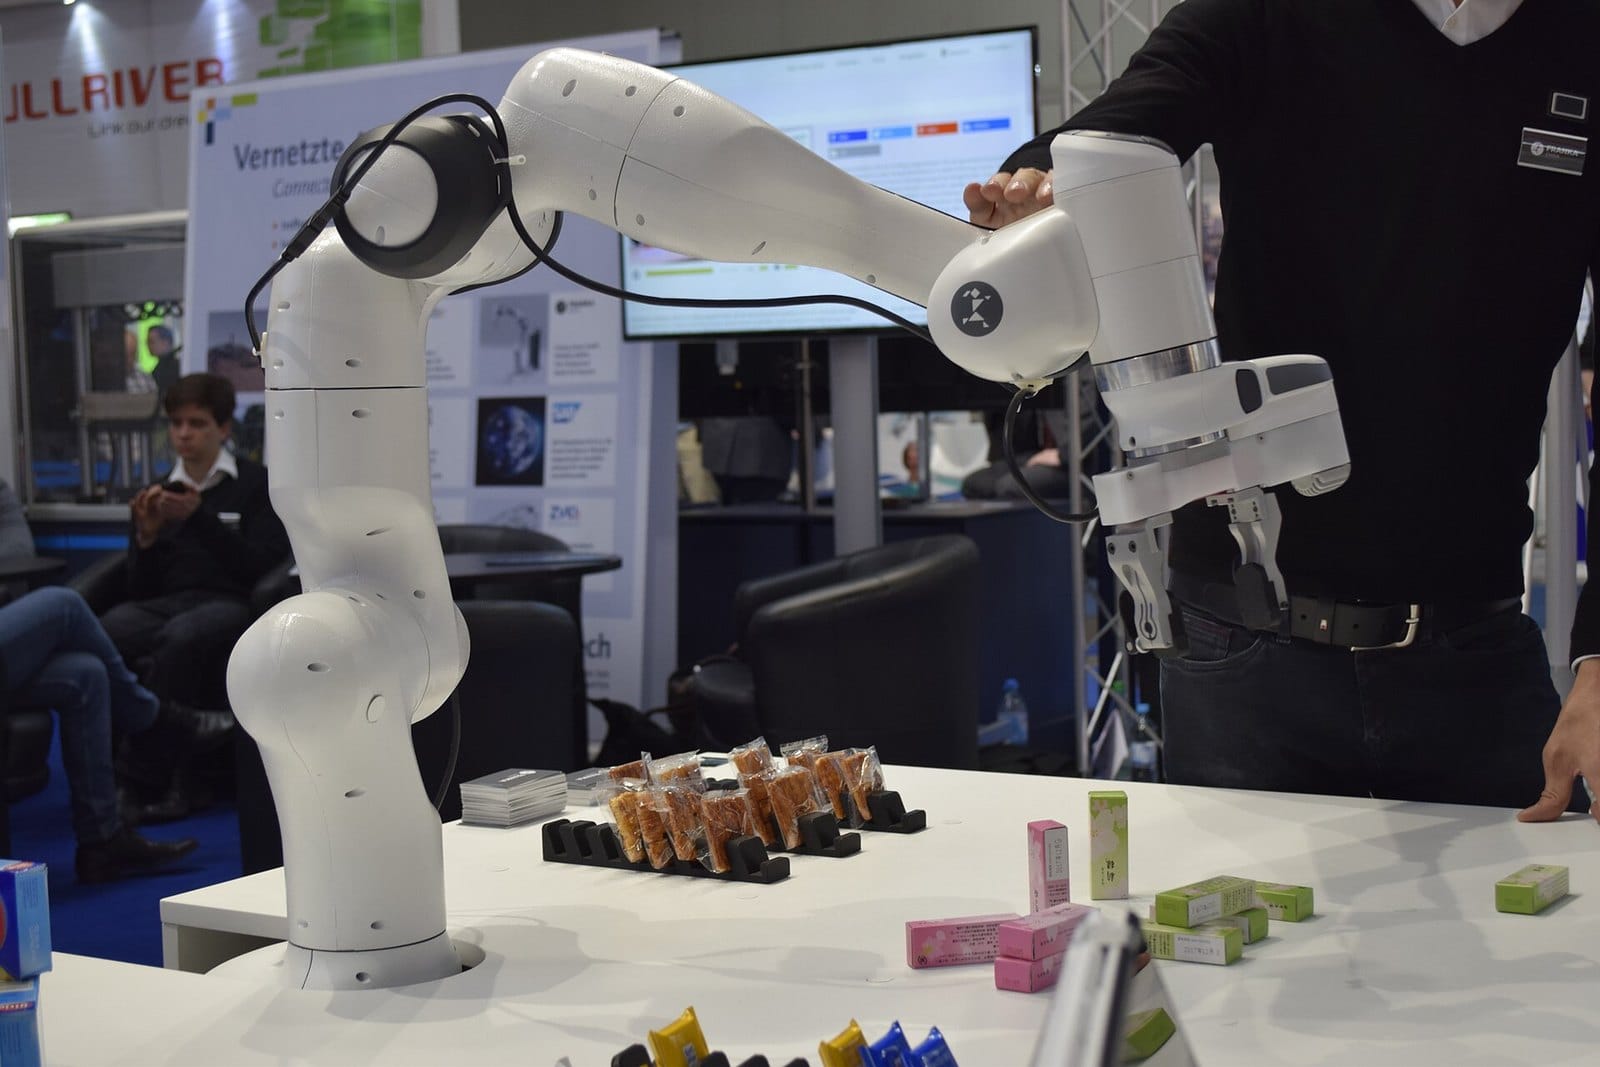
สูตรจำง่าย: VLM ต่างจาก VLA อย่างไร
ความต่างอยู่ที่ VLA ต้องผลิต Action ที่ควบคุมฮาร์ดแวร์ได้จริง ซึ่งต้องแม่นทั้งตำแหน่ง แรง และเวลา
7. Physical AI vs Embodied AI vs VLA
| 部分 | Physical AI | Embodied AI | VLA |
|---|---|---|---|
| ประเภท | Umbrella / Ecosystem | Concept / Agent | Model |
| Scope | ใหญ่มาก | ระดับ Agent | ระดับ Model |
| ต้องมีโลกกายภาพ | เป็นแกนหลัก | เป็นแกนหลัก | เป้าหมายมักเป็น Robot Action |
| ต้องมี Body | ไม่จำเป็นทุกกรณี | โดยแนวคิดต้องมี Embodiment | ไม่จำเป็นตอน Train |
| รับภาพ | มักมี | มักมี | ✅ มี |
| รับภาษา | อาจมี | อาจมี | ✅ มี |
| สร้าง Action | มักมี | มักมี | ⭐ เป็นจุดเด่นหลัก |
| ใช้ World Model | อาจใช้ | อาจใช้ | อาจทำงานร่วมกัน |
| ใช้ Simulation | สำคัญมาก | สำคัญ | ใช้สร้าง/เพิ่ม Training Data ได้ |
| ตัวอย่าง | Humanoid ecosystem | Robot interacting with environment | Vision + Command → Robot Action |
8. World Model คืออะไร?
World Model ตอบคำถามที่ต่างจาก VLA อย่างชัดเจน
Current State → Robot ดันแก้ว → World Model → Predict Future
   ↓
แก้วจะเคลื่อน / ชน / ตกโต๊ะหรือไม่
จากนั้น Planner สามารถเปรียบเทียบหลาย Action ก่อนตัดสินใจ:
Action A → ชนจาน   ❌
Action B → ผ่านได้  ✅
Action C → ตกโต๊ะ  ❌
9. Robot Foundation Model คืออะไร?
Robot Foundation Model (RFM) เป็นคำที่กว้างกว่า VLA เพราะครอบคลุมหลายความสามารถไว้ในโมเดลพื้นฐานเดียว
Robot Foundation Model
        ├── Vision / Perception
        ├── Language / Reasoning
        ├── VLA
        ├── Robot Policy
        ├── World Model
        └── Planning
เป้าหมายคือทำให้หุ่นยนต์หนึ่งระบบรองรับ หลาย Task / หลาย Environment / หลาย Hardware ได้ มากกว่าการเขียนโปรแกรมแยกทีละงาน ซึ่งเป็นทิศทางเดียวกับที่ผู้ผลิตหุ่นยนต์ฮิวแมนนอยด์รายใหญ่กำลังมุ่งไป — อ่านเพิ่มเติมได้ที่ เปรียบเทียบ Tesla Optimus vs Unitree G1 vs Figure 01
10. วิธีฝึก Robot AI ยุคใหม่
10.1 Imitation Learning
มนุษย์สาธิต → เก็บ Observation + Action → หุ่นยนต์เรียนตาม
Human Demonstration → Camera / Joint / Force Data
   → Training Dataset → Robot Policy
10.2 Reinforcement Learning
หุ่นยนต์ทดลอง Action → Environment ให้ Reward → Policy ถูกปรับ
Robot --Action--> Environment --Reward--> Learning Algorithm
   → Improved Policy
10.3 Simulation + Sim-to-Real
ฝึกใน Simulation จำนวนมาก ก่อนนำ Policy ลง Hardware จริง ข้อดีคือ
- 🛡️ลดความเสียหายของหุ่นยนต์จริง
- ⚡ทำ Training แบบ Parallel ได้
- 🔥สร้างสถานการณ์อันตรายได้โดยไม่มีความเสี่ยง
- 📊Generate Data ปริมาณมากได้
- 🎯ทดสอบ Corner Case ได้ง่ายกว่าในโลกจริง
11. ตัวอย่างระบบจริงแบบ End-to-End
คำสั่ง: “ช่วยเอาขวดน้ำบนโต๊ะมาให้ผม”
| ขั้น | 科技 | หน้าที่ |
|---|---|---|
| 1 | Camera / LiDAR | มองและวัด Environment |
| 2 | Perception / VLM | หาโต๊ะ คน และขวด |
| 3 | LLM / Reasoning | เข้าใจเจตนาของคำสั่ง |
| 4 | World Model | คาดการณ์ผลของการเดิน/หยิบ |
| 5 | Planner | วางลำดับงาน |
| 6 | VLA / Robot Policy | สร้าง Action |
| 7 | Motion Planner | สร้าง Path / Trajectory |
| 8 | Controller | ควบคุม Joint / Motor |
| 9 | Force / Vision Feedback | ตรวจว่าจับสำเร็จหรือไม่ |
| 10 | Re-planning | ปรับแผนหากสถานการณ์เปลี่ยน |
จะเห็นว่าขั้นที่ 7–9 ต้องอาศัยการออกแบบมือและกลไกจับยึดโดยเฉพาะ ซึ่งเป็นคอขวดสำคัญของงาน Manipulation — เจาะลึกได้ที่ กายวิภาคของมือหุ่นยนต์: 5 สถาปัตยกรรม Dextrous Hand ที่ขับเคลื่อนยุค Physical AI
12. คำศัพท์ที่นักศึกษาวิศวกรรมควรรู้เพิ่ม
ถ้าต้องการเริ่มลงมือเขียนโปรแกรมควบคุมหุ่นยนต์จริง เริ่มได้จาก Humanoid Programming 101
สรุปสุดท้าย
Physical AI    = ภาพรวมของ AI ที่ทำงานในโลกกายภาพ
Embodied AI    = AI ที่มี Body + Sensor + Action และเรียนรู้จาก Environment
VLA            = โมเดลที่เชื่อม Vision + Language → Action
World Model    = โมเดลที่ทำนายว่า Action จะทำให้โลกเปลี่ยนอย่างไร
Robot Policy   = โมเดลที่ตัดสินใจว่า Robot ต้องทำ Action อะไร
Planner        = วางแผนลำดับงาน
Controller     = ทำให้ Action กลายเป็นการเคลื่อนไหวจริง
FAQ: คำถามที่พบบ่อยเกี่ยวกับ VLA และ Physical AI
❓ VLA คืออะไร?
VLA ย่อมาจาก Vision-Language-Action เป็นโมเดล AI ที่รับข้อมูลภาพจากกล้องและคำสั่งภาษาจากมนุษย์ แล้วสร้างคำสั่งการเคลื่อนไหว (Action) ให้หุ่นยนต์ทำงานจริง ต่างจาก VLM ตรงที่ VLA ต้องผลิต Action ที่ควบคุมฮาร์ดแวร์ได้ ไม่ใช่แค่บรรยายภาพ
❓ Physical AI ต่างจาก Embodied AI อย่างไร?
Physical AI เป็นคำร่ม (umbrella) ที่หมายถึง AI ทั้งระบบนิเวศที่ทำงานในโลกกายภาพ ส่วน Embodied AI เจาะจงกว่า คือ AI ที่มีร่างกาย (Embodiment) และเรียนรู้ผ่านการรับรู้และลงมือทำในสภาพแวดล้อม พูดง่าย ๆ คือ Embodied AI เป็นส่วนหนึ่งที่อยู่ภายใต้ Physical AI
❓ VLA กับ World Model ต่างกันตรงไหน?
VLA ตอบคำถามว่า “ตอนนี้ควรทำอะไร” ส่วน World Model ตอบว่า “ถ้าทำแบบนี้แล้วจะเกิดอะไรขึ้น” ทั้งสองมักทำงานร่วมกัน โดย World Model ช่วยให้ Planner ประเมินผลลัพธ์ล่วงหน้าก่อนเลือก Action
❓ ต้องมีหุ่นยนต์จริงถึงจะเรียน VLA ได้ไหม?
ไม่จำเป็นในขั้นเริ่มต้น ปัจจุบันสามารถฝึกและทดสอบใน Simulation เช่น Isaac Sim หรือ MuJoCo ได้ก่อน แล้วค่อยทำ Sim-to-Real เมื่อมีฮาร์ดแวร์ ซึ่งเป็นแนวทางมาตรฐานของงานวิจัยหุ่นยนต์ยุคใหม่
❓ Robot Foundation Model กับ VLA ต่างกันอย่างไร?
VLA เป็นโมเดลประเภทหนึ่ง ส่วน Robot Foundation Model เป็นโมเดลพื้นฐานขนาดใหญ่ที่อาจรวม VLA, World Model, Planner และ Perception ไว้ด้วยกัน เพื่อให้หุ่นยนต์ตัวเดียวทำได้หลายงานโดยไม่ต้องเขียนโปรแกรมแยกทีละงาน