태국 드론 협회

สมัครสมาชิก☰

Article

รวบรวทบทความทุกหมวดหมู่

ภาพโมเดล Cosmos 3 Edge ของ NVIDIA
AI Article

Cosmos 3 Edge ของ NVIDIA ดันโลกจำลองไปอยู่บนอุปกรณ์ปลายทาง

ข่าวของ NVIDIA Cosmos 3 Edge น่าสนใจตรงที่มันไม่พยายามเป็นโมเดลยักษ์ในดาต้าเซ็นเตอร์ แต่พยายามย้ายสมองของการมองโลก การคิด และการสั่งการไปไว้บนเครื่องปลายทางแทน โมเดลนี้มีขนาด 4B parameters และออกแบบให้รันแบบ on-device เพื่อให้หุ่นยนต์และ vision AI agent ตอบสนองได้แบบเรียลไทม์ในสภาพแวดล้อมที่สัญญาณเน็ตไม่ใช่ของสำคัญที่สุด ภาพ: NVIDIA สำหรับคนทำโดรน ข่าวนี้ไม่ได้เป็นเพียงเรื่องของหุ่นยนต์พื้นราบหรือเครื่องจักรในโรงงาน แต่เป็นสัญญาณว่าระบบตัดสินใจบนอุปกรณ์เล็ก ๆ กำลังเข้าสู่ระดับที่จริงจังขึ้น หากโมเดลลักษณะนี้ทำงานได้โดยไม่ต้องพึ่งคลาวด์ตลอดเวลา ก็เท่ากับเปิดทางให้โดรนอัตโนมัติทำงานในพื้นที่ที่สัญญาณอ่อน เช่น ป่า ชายแดน หรือพื้นที่ห่างไกลจากโครงข่ายหลัก โลกจำลองที่ไม่ได้มีไว้ดูเท่ คำว่า world model ฟังดูเหมือนศัพท์ที่ใช้ในงานวิจัยมากกว่างานปฏิบัติ แต่แก่นของมันค่อนข้างตรงไปตรงมา โมเดลแบบนี้พยายามเรียนรู้ว่าโลกเปลี่ยนอย่างไรเมื่อมีการกระทำเกิดขึ้น มันวิเคราะห์ตำแหน่งของวัตถุ

Cosmos 3 Edge ของ NVIDIA ดันโลกจำลองไปอยู่บนอุปกรณ์ปลายทาง 게시물 읽기"

ภาพ Alpamayo 2 Super ของ NVIDIA
AI Article

Alpamayo 2 Super ของ NVIDIA ทำให้รถไร้คนขับกับโดรนยิ่งเข้าใกล้กัน

NVIDIA Alpamayo 2 Super เป็นข่าวที่ดูเหมือนอยู่ในโลกของรถยนต์ล้วน ๆ แต่จริง ๆ แล้วมันพูดถึงแกนเทคโนโลยีที่คนทำโดรนคุ้นมากกว่าเดิม: การมองภาพ การตีความภาษา การคาดการณ์การเคลื่อนที่ และการแปลงการตัดสินใจออกมาเป็นการกระทำ โมเดลนี้มีขนาด 34B parameters และวางตัวเป็น vision-language-action (VLA) สำหรับงานขับขี่อัตโนมัติ โดยเฉพาะสถานการณ์ยาก ๆ แบบ long-tail events ภาพ: NVIDIA จุดที่ทำให้มันน่าสนใจคือ NVIDIA ไม่ได้มองโมเดลนี้เป็นแค่เครื่องทำนายเส้นทาง แต่ให้มันอธิบายที่มาของการตัดสินใจได้ด้วย ในหนึ่งรอบ โมเดลสามารถสร้าง trajectory, ข้ออธิบายเชิงเหตุผล และ meta-action ออกมาพร้อมกัน แนวคิดแบบนี้คือเหตุผลว่าทำไมคนทำโดรนถึงควรอ่านข่าวนี้ แม้ชื่อผลิตภัณฑ์จะไปอยู่ฝั่งรถยนต์

Alpamayo 2 Super ของ NVIDIA ทำให้รถไร้คนขับกับโดรนยิ่งเข้าใกล้กัน 게시물 읽기"

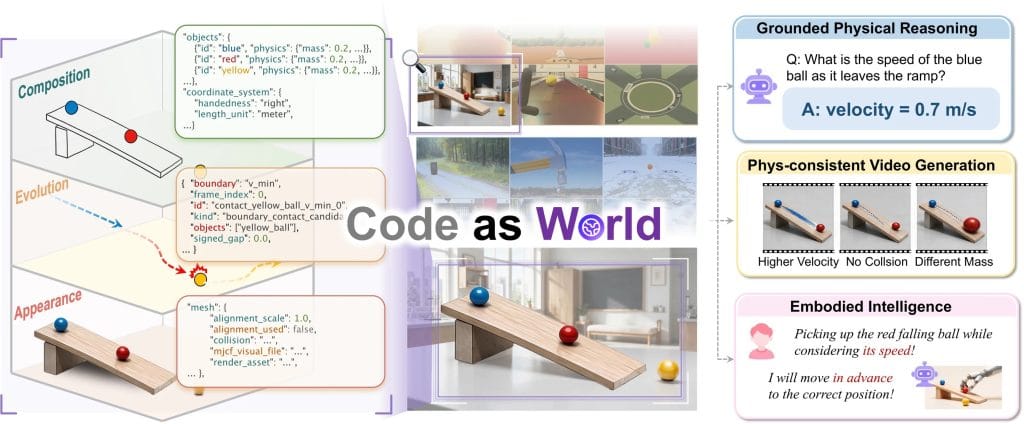
Code-as-World จาก MirroS-Lab
AI Article

Code-as-World เปลี่ยนวิดีโอจริงให้กลายเป็นโปรแกรมฟิสิกส์ MuJoCo ที่รันและตรวจสอบได้

แนวคิดของ Code-as-World น่าสนใจเพราะมันไม่พยายามทำนายวิดีโอให้เหมือนภาพจริงอย่างเดียว แต่พยายามสร้าง “โลกที่รันได้” จากวิดีโอจริงแทน ถ้าทำได้จริง นี่คือการเปลี่ยนข้อมูลภาพจากหลักฐานเฉย ๆ ให้กลายเป็นโปรแกรมที่จำลองฟิสิกส์ ตรวจสอบ และแก้ไขต่อได้ ภาพ: MirroS-Lab แก่นของแนวคิดคือ pixels ไม่ใช่ตัวตนของโลก ทีม MirroS วางข้อเสนอว่า pixel เป็นแค่หลักฐานของฉาก ไม่ใช่ ontology ของมัน ดังนั้นแทนที่จะเก็บโลกไว้เป็นภาพหรือคำบรรยาย ระบบนี้แทนฉากเป็น executable code หรือ scene.json ที่รันใน MuJoCo ได้ จุดนี้ทำให้โลกจำลองไม่ได้เป็นแค่ภาพสวย แต่กลายเป็นสิ่งที่ agent ตรวจสอบต่อได้ ว่าแรง มวล

Code-as-World เปลี่ยนวิดีโอจริงให้กลายเป็นโปรแกรมฟิสิกส์ MuJoCo ที่รันและตรวจสอบได้ 게시물 읽기"

Genesis World 1.0 จาก Genesis AI
AI Article

Genesis AI เปิด Nyx, Quadrants และ Genesis World 1.0 แพลตฟอร์มฟิสิกส์สำหรับประเมินหุ่นยนต์ได้เร็วขึ้น

ถ้าทีมหุ่นยนต์จะชนะกันจริง สิ่งที่ชนะอาจไม่ใช่แค่โมเดลที่ฉลาดที่สุด แต่คือทีมที่ประเมินได้เร็วที่สุด ข่าวของ Genesis AI ชี้ตรงจุดนี้ เพราะแพลตฟอร์มใหม่ของเขาไม่ได้เริ่มจากการฝึกอย่างเดียว แต่เริ่มจากการทำให้การทดสอบหุ่นยนต์ในโลกจำลองเร็วและเชื่อถือได้มากขึ้น ภาพ: Genesis AI Genesis World 1.0 คืออะไร แพลตฟอร์มนี้มี 4 ส่วน คือ physics engine, Nyx renderer, Quadrants compiler และ simulation interface เป้าหมายคือทำให้การประเมิน robotics foundation model ทำได้ในเวลาสั้นลง โดยไม่ต้องใช้คนและฮาร์ดแวร์จริงทุกครั้ง Genesis AI ระบุว่าการประเมินหนึ่งรอบในโลกจริงอาจกินเวลากว่า 200 ชั่วโมง

Genesis AI เปิด Nyx, Quadrants และ Genesis World 1.0 แพลตฟอร์มฟิสิกส์สำหรับประเมินหุ่นยนต์ได้เร็วขึ้น 게시물 읽기"

Robostral Navigate จาก Mistral AI
AI Article

Mistral AI เปิด Robostral Navigate โมเดล 8B ที่พาหุ่นยนต์เดินในพื้นที่ซับซ้อนด้วยกล้อง RGB เพียงตัวเดียว

การนำทางของหุ่นยนต์มักแพงเพราะต้องพึ่งเซนเซอร์หลายชั้น ข่าวของ Robostral Navigate จาก Mistral AI จึงน่าสนใจตรงที่พยายามตัดความซับซ้อนลงเหลือแค่ RGB camera ตัวเดียว แต่ยังทำงานในพื้นที่จริงที่มีคนและสิ่งกีดขวางได้ ภาพ: Mistral AI โมเดลนี้ทำอะไร Robostral Navigate เป็นโมเดลขนาด 8B สำหรับการนำทางในสภาพแวดล้อมซับซ้อน เช่น สำนักงาน อาคารพักอาศัย อาคารพาณิชย์ และพื้นที่กลางแจ้ง ผู้ใช้ให้คำสั่งภาษาธรรมดา แล้วโมเดลตัดสินใจว่าจะให้หุ่นยนต์เคลื่อนที่อย่างไรต่อเนื่องจนจบภารกิจ ตัวอย่างในต้นฉบับคือคำสั่งแบบ “ออกจากล็อบบี้ เดินไปทางทางเดิน เข้าห้องเก็บของ แล้วหยุดหันหน้าไปยังชั้นวางที่สอง” จุดต่างคือใช้การ pointing แทนการสั่งแบบเดิม แทนที่จะสั่งเป็นระยะทางเชิงตัวเลขอย่างเดียว โมเดลใช้วิธี pointing มันคาดเดาพิกัดเป้าหมายในภาพปัจจุบันและทิศทางเมื่อไปถึงจุดนั้น

Mistral AI เปิด Robostral Navigate โมเดล 8B ที่พาหุ่นยนต์เดินในพื้นที่ซับซ้อนด้วยกล้อง RGB เพียงตัวเดียว 게시물 읽기"

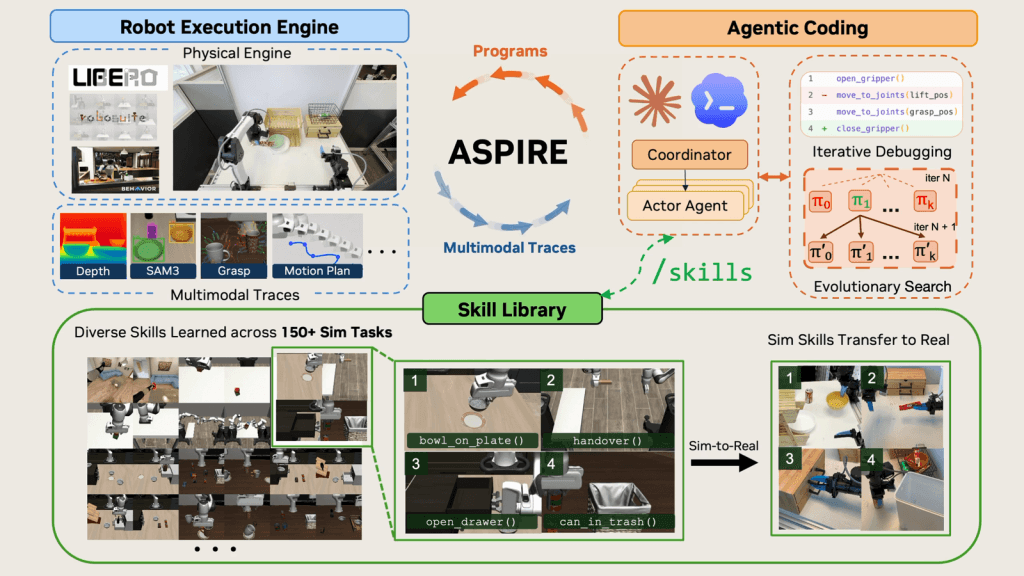
ASPIRE จาก NVIDIA Research
AI Article

NVIDIA เปิด ASPIRE เฟรมเวิร์กหุ่นยนต์ที่พัฒนาความสามารถตัวเองได้จากการดีบักและเรียนรู้ซ้ำ

ปัญหาใหญ่ของหุ่นยนต์ไม่ได้อยู่ที่มันทำงานไม่ได้เลย แต่อยู่ที่พอมันพลาดแล้วเรามักไม่รู้ว่าพลาดตรงไหน ข่าวของ ASPIRE จาก NVIDIA จึงน่าสนใจ เพราะมันพยายามเปลี่ยนหุ่นยนต์จากระบบที่รันครั้งเดียวจบ ไปเป็นระบบที่ “เรียนรู้จากการดีบักของตัวเอง” แล้วเก็บความรู้ไว้ใช้ต่อ ภาพ: NVIDIA Research ASPIRE คืออะไร ชื่อเต็มของมันคือ Agentic Skill Programming through Iterative Robot Exploration แนวคิดหลักคือให้ coding agent เขียนและปรับโปรแกรมควบคุมหุ่นยนต์ไปเรื่อย ๆ แล้วคัดเฉพาะวิธีแก้ที่ตรวจสอบแล้วเข้าสู่ skill library ที่นำกลับมาใช้ได้ การออกแบบนี้ช่วยแก้ปัญหาคลาสสิกของระบบหุ่นยนต์แบบเดิมที่มักได้แค่ feedback ว่า “งานล้มเหลว” แต่ไม่รู้ว่าสาเหตุมาจาก perception, grasping,

NVIDIA เปิด ASPIRE เฟรมเวิร์กหุ่นยนต์ที่พัฒนาความสามารถตัวเองได้จากการดีบักและเรียนรู้ซ้ำ 게시물 읽기"

LingBot-VA 2.0 จาก Robbyant
AI Article

LingBot-VA 2.0 โมเดล video-action ที่แยกจาก VLA ชัดเจนและเน้นการคาดการณ์ฟิสิกส์ของโลก

ชื่อ LingBot-VA 2.0 คล้ายกับ LingBot-VLA 2.0 มาก แต่สองตัวนี้ไม่ใช่โมเดลเดียวกัน และไม่ควรเขียนรวมกันแบบหลวม ๆ เพราะโจทย์ของมันต่างกันคนละชั้น ภาพ: Robbyant ถ้า VLA คือภาพ + ภาษา -> การกระทำ, VA ในเวอร์ชันนี้คือการทำให้วิดีโอและการกระทำเชื่อมกันบนสถาปัตยกรรมที่ออกแบบมาเพื่อ causal video-action โดยตรง ต่างจาก VLA ตรงไหน LingBot-VLA 2.0 ในข่าวก่อนหน้าเน้นการควบคุมหุ่นยนต์จากภาพและคำสั่งภาษา ขณะที่ LingBot-VA 2.0 ถูกวางให้เป็น foundation model สำหรับวิดีโอและการกระทำที่เรียนรู้แบบ causal ตั้งแต่ต้น

LingBot-VA 2.0 โมเดล video-action ที่แยกจาก VLA ชัดเจนและเน้นการคาดการณ์ฟิสิกส์ของโลก 게시물 읽기"

LingBot-VLA 2.0 จาก Robbyant
AI Article

Robbyant เปิด LingBot-VLA 2.0 โมเดลหุ่นยนต์ 6B แบบโอเพนซอร์สที่ย้ายงานข้ามแพลตฟอร์มได้

ถ้าปัญหาของหุ่นยนต์คือการทำให้ “แขนคนละแบบ” เข้าใจงานเดียวกัน ข่าวของ LingBot-VLA 2.0 ก็น่าจะถูกใจคนทำระบบอัตโนมัติพอสมควร เพราะโมเดลนี้ไม่ได้มองแค่ว่าหุ่นยนต์ตัวไหนทำงานอะไรได้ แต่พยายามสร้างภาษากลางให้หุ่นยนต์หลายรูปแบบคุยกับโมเดลเดียวกันได้ ภาพ: Robbyant โมเดลหลักคือ VLA สำหรับ cross-embodiment LingBot-VLA 2.0 เป็นโมเดล 6B แบบ open-source ที่ทำงานในกรอบ vision-language-action มันรับภาพจากกล้องกับคำสั่งภาษา แล้วแปลงเป็นแอ็กชันของหุ่นยนต์ จุดขายสำคัญคือความสามารถแบบ cross-embodiment หรือการย้ายความเข้าใจจากหุ่นยนต์ชนิดหนึ่งไปยังอีกชนิดหนึ่ง Robbyant ระบุว่ารุ่นนี้ต่อยอดจากเวอร์ชันก่อนในสามด้านคือ generalization, action space ที่กว้างขึ้น และ predictive dynamics เรื่องใหญ่ไม่ใช่แค่โมเดล แต่คือ data

Robbyant เปิด LingBot-VLA 2.0 โมเดลหุ่นยนต์ 6B แบบโอเพนซอร์สที่ย้ายงานข้ามแพลตฟอร์มได้ 게시물 읽기"

ชุดโมเดล Qwen-RobotSuite
AI Article

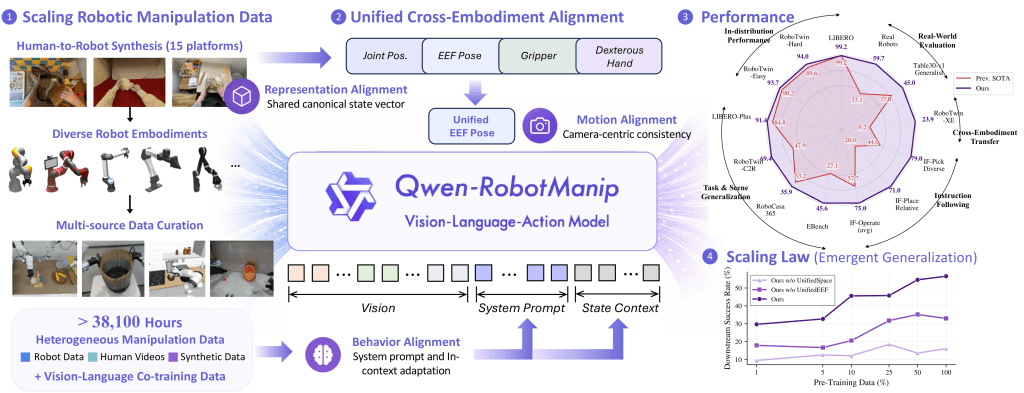
Alibaba เปิด Qwen-RobotSuite ชุดโมเดลหุ่นยนต์ 3 ตัวที่เน้นความคุ้มค่าและขยายงานได้จริง

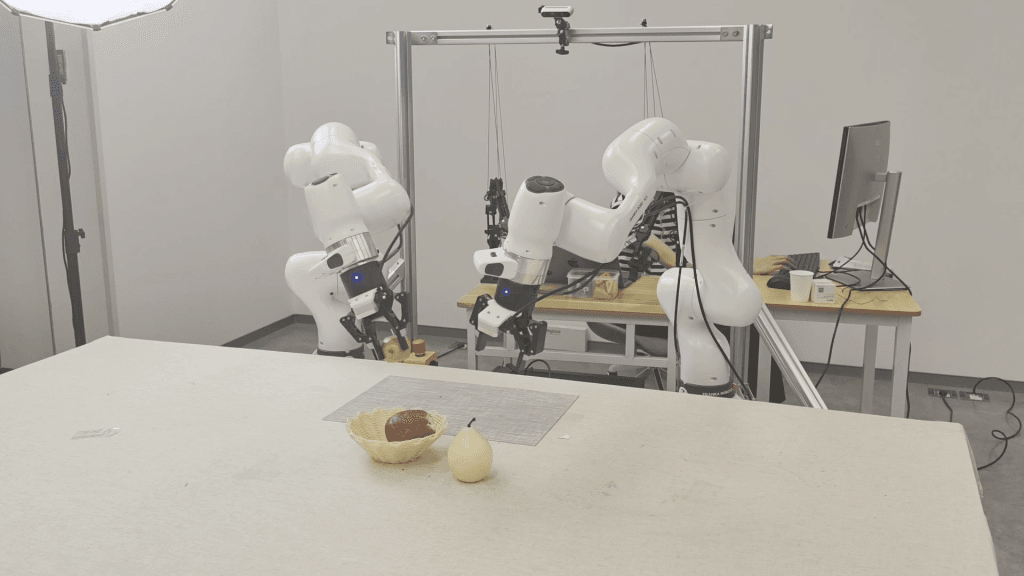
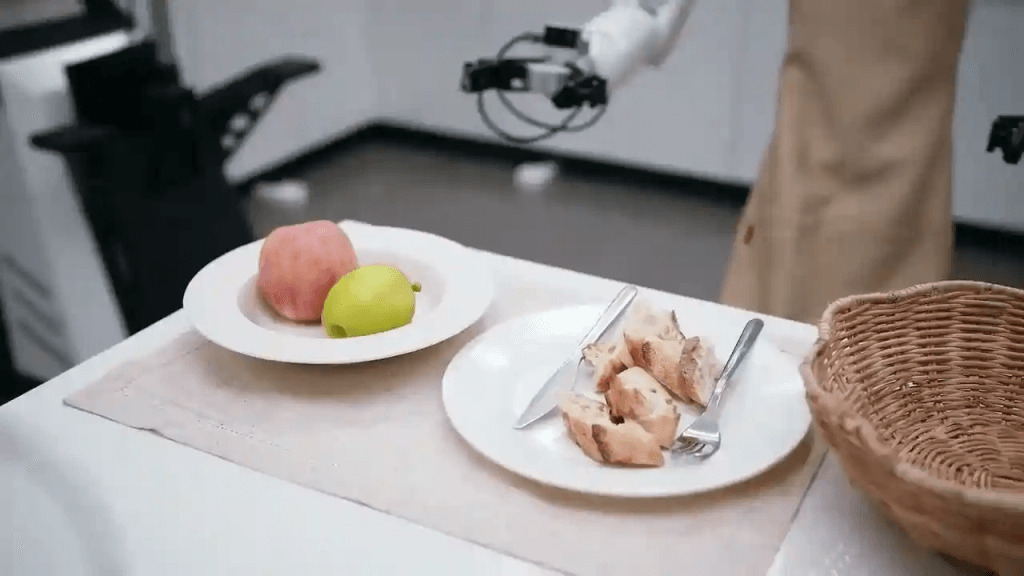
ตลาดหุ่นยนต์ไม่ได้ขาดโมเดลที่เก่งในห้องแล็บ แต่ขาดโมเดลที่เอาไปใช้จริงได้ในราคาที่องค์กรรับไหว ข่าวของ Qwen-RobotSuite จาก Alibaba จึงน่าสนใจตรงที่ไม่ได้พยายามขาย “หุ่นยนต์อัจฉริยะหนึ่งตัว” แต่เสนอเป็นชุดเครื่องมือ 3 โมเดล ที่แยกตามงานชัดเจน ตั้งแต่การหยิบจับ การจำลองโลกจากวิดีโอ ไปจนถึงการนำทาง ภาพ: Alibaba Qwen ไม่ใช่โมเดลเดียว แต่เป็น 3 ชั้นของงานหุ่นยนต์ ในชุดนี้มี Qwen-RobotManip, Qwen-RobotWorld และ Qwen-RobotNav RobotManip เป็น VLA model สำหรับงาน manipulation หรือการควบคุมแขนและมือให้หยิบจับ เคลื่อนย้าย และจัดวางวัตถุ RobotWorld เป็น video world

Alibaba เปิด Qwen-RobotSuite ชุดโมเดลหุ่นยนต์ 3 ตัวที่เน้นความคุ้มค่าและขยายงานได้จริง 게시물 읽기"

Google DeepMind เปิดตัวโมเดลหุ่นยนต์ใหม่
AI Article

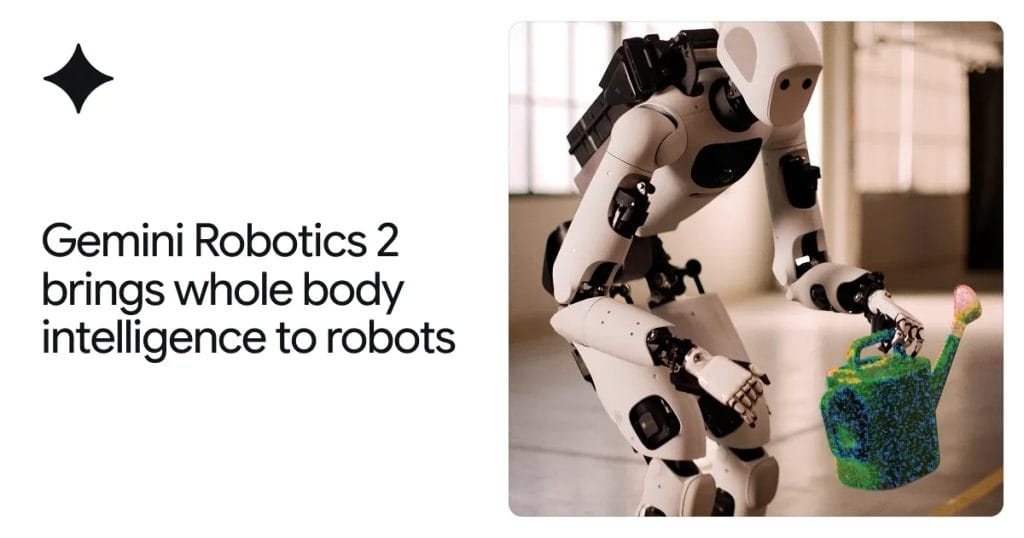
Google DeepMind เปิดยุคใหม่ของ Physical AI ด้วย Gemini Robotics 2 และโมเดลแยกหน้าที่ 3 ตัว

Google DeepMind ส่งสัญญาณชัดว่าเกมหุ่นยนต์กำลังขยับจาก “หยิบของบนโต๊ะ” ไปสู่การควบคุมทั้งร่างกาย การใช้มือที่ละเอียดขึ้น และการทำงานร่วมกันของหุ่นยนต์หลายตัวพร้อมกัน ข่าวนี้ไม่ใช่แค่การเปิดตัวโมเดลใหม่ แต่เป็นการจัดสถาปัตยกรรมใหม่ให้หุ่นยนต์มีสมองหลายชั้น แยกงานวางแผน งานสั่งการ และงานรันบนตัวหุ่นยนต์ออกจากกันอย่างเป็นระบบ ภาพ: Google DeepMind 3 โมเดลที่ไม่ได้ทำงานแบบเดียวกัน ในชุดนี้ DeepMind แยกออกเป็น 3 โมเดล ซึ่งมีหน้าที่ต่างกันชัดเจน ตัวแรกคือ Gemini Robotics 2 โมเดลแบบ vision-language-action หรือ VLA ที่แปลงภาพกับคำสั่งให้กลายเป็นการเคลื่อนไหวของหุ่นยนต์ มันถูกออกแบบให้คุมได้ตั้งแต่เท้าถึงปลายนิ้ว ไม่ได้จำกัดแค่แขนหยิบจับบนโต๊ะอีกต่อไป ตัวที่สองคือ Gemini Robotics ER 2 ซึ่งเป็นโมเดลสาย

Google DeepMind เปิดยุคใหม่ของ Physical AI ด้วย Gemini Robotics 2 และโมเดลแยกหน้าที่ 3 ตัว 게시물 읽기"

위로 스크롤