
runtime ที่รองรับโมเดลจำนวนมากให้ความยืดหยุ่น แต่ต้องรักษาโค้ดให้ใช้ซ้ำข้ามสถาปัตยกรรม Perplexity เลือกอีกทางด้วย Lily inference engine ที่จงใจปรับเฉพาะโมเดล Qwen3.6-35B-A3B บน Apple silicon เพื่อรีดความเร็วจากโครงสร้างชิปและ unified memory โดยตรง โครงการนี้เป็นกลไก local inference เบื้องหลัง Hybrid Compute ของ Perplexity Computer และถูกเปิดซอร์สให้ทดลองผ่าน repository pplx-garden
ตัวระบบทำงานใน process เดียว ชั้น Rust โหลด checkpoint และควบคุมวงจรสร้างข้อความ ส่วน Metal kernel ที่เขียนเฉพาะประมวลผลโมเดล มี API แบบ chat completions ที่เข้ากันกับรูปแบบของ OpenAI และสตรีม token ได้ ระหว่าง inference ไม่มีทั้ง PyTorch 및 MLX อยู่ในเส้นทางทำงาน ความเฉพาะทางนี้เป็นทั้งเหตุผลที่เร็วและขอบเขตที่ทำให้ Lily ไม่ใช่ runtime ครอบจักรวาล
โมเดลใหญ่ แตะน้ำหนักเพียงบางส่วนต่อ token
Qwen3.6-35B-A3B เก็บพารามิเตอร์ 35 พันล้านตัว แต่เปิดใช้ราว 3 พันล้านตัวต่อ token router ให้คะแนน expert 256 ตัว แล้วเลือก 8 ตัว พร้อม shared expert อีกหนึ่งตัว โครงสร้างผสม full-attention 10 ชั้น กับ Gated DeltaNet 30 ชั้น จึงมีภาระงานสามแบบพร้อมกัน ได้แก่ กลุ่ม expert ที่มีขนาดไม่เท่ากัน attention ที่ KV cache โตตาม context และ recurrence ขนาดคงที่
checkpoint ใช้ groupwise affine quantization แบบ 4-bit โดยน้ำหนักทุก 64 ค่า แชร์ scale และ bias แบบ bfloat16 น้ำหนักเดิมราว 70GB ใน bfloat16 จึงย่อลงเหลือ 19.4GB เนื่องจาก Metal tensor operation ใช้ bfloat16, Lily จะคืนค่าน้ำหนักทีละ tile ภายใน grouped GEMM เก็บผลไว้ใน threadgroup memory และสะสมแบบ FP32 ทำให้อาร์เรย์ที่ขยายแล้วไม่ต้องไหลกลับไปยัง unified memory
จากการทดสอบแยกองค์ประกอบของ Perplexity การรวมขั้นตอนนี้เพิ่มความเร็ว end-to-end prefill 77.4% ที่ prompt 512 tokens การเก็บ routing histogram, prefix scan, scatter และ block map ใน GPU command buffer เดียวเพิ่มอีก 89% ที่ความยาวเดียวกัน เพราะลดการรอประสานกับ CPU ส่วนการเปลี่ยน tile จาก 16 แถวเป็น 32 แถว เพิ่ม 13.2% ที่ 2K tokens และ Gated DeltaNet scan ใน register เพิ่ม 5.6%
Decode ถูกจำกัดด้วยแบนด์วิดท์มากกว่าการคำนวณ
เมื่อ batch เท่ากับหนึ่ง น้ำหนักแทบไม่ถูกใช้ซ้ำ เพดานความเร็วจึงอยู่ที่จำนวน byte ที่ย้ายได้ การ decode หนึ่งขั้นที่บันทึกไว้เรียก 795 kernels แบ่งเป็น 555 ลำดับต่อเนื่อง Lily ระบุ dependency จริงใน Metal pass แบบทำงานพร้อมกัน เพื่อให้ kernel ที่ไม่ต้องรอกันซ้อนเวลาได้ และเขียน token ที่เลือกลง input slot บน GPU สำหรับรอบถัดไปทันที ไม่ต้องวิ่งกลับ CPU ทุก token
การอ่าน cache ต่อเนื่องเพิ่มแบนด์วิดท์ของ key จาก 33.8 เป็น 47.9 GB/s และ value จาก 42.0 เป็น 61.8 GB/s การจัดแพ็ก GQA ให้ query head สี่ตัวใช้ threadgroup เดียวกันเพิ่มความเร็ว decode 23.8% ที่ context 32K ส่วน fixed-block attention ช่วยเพิ่ม 7.7% ที่ 32K, 27.4% ที่ 64K 및 40.2% ที่ 128K
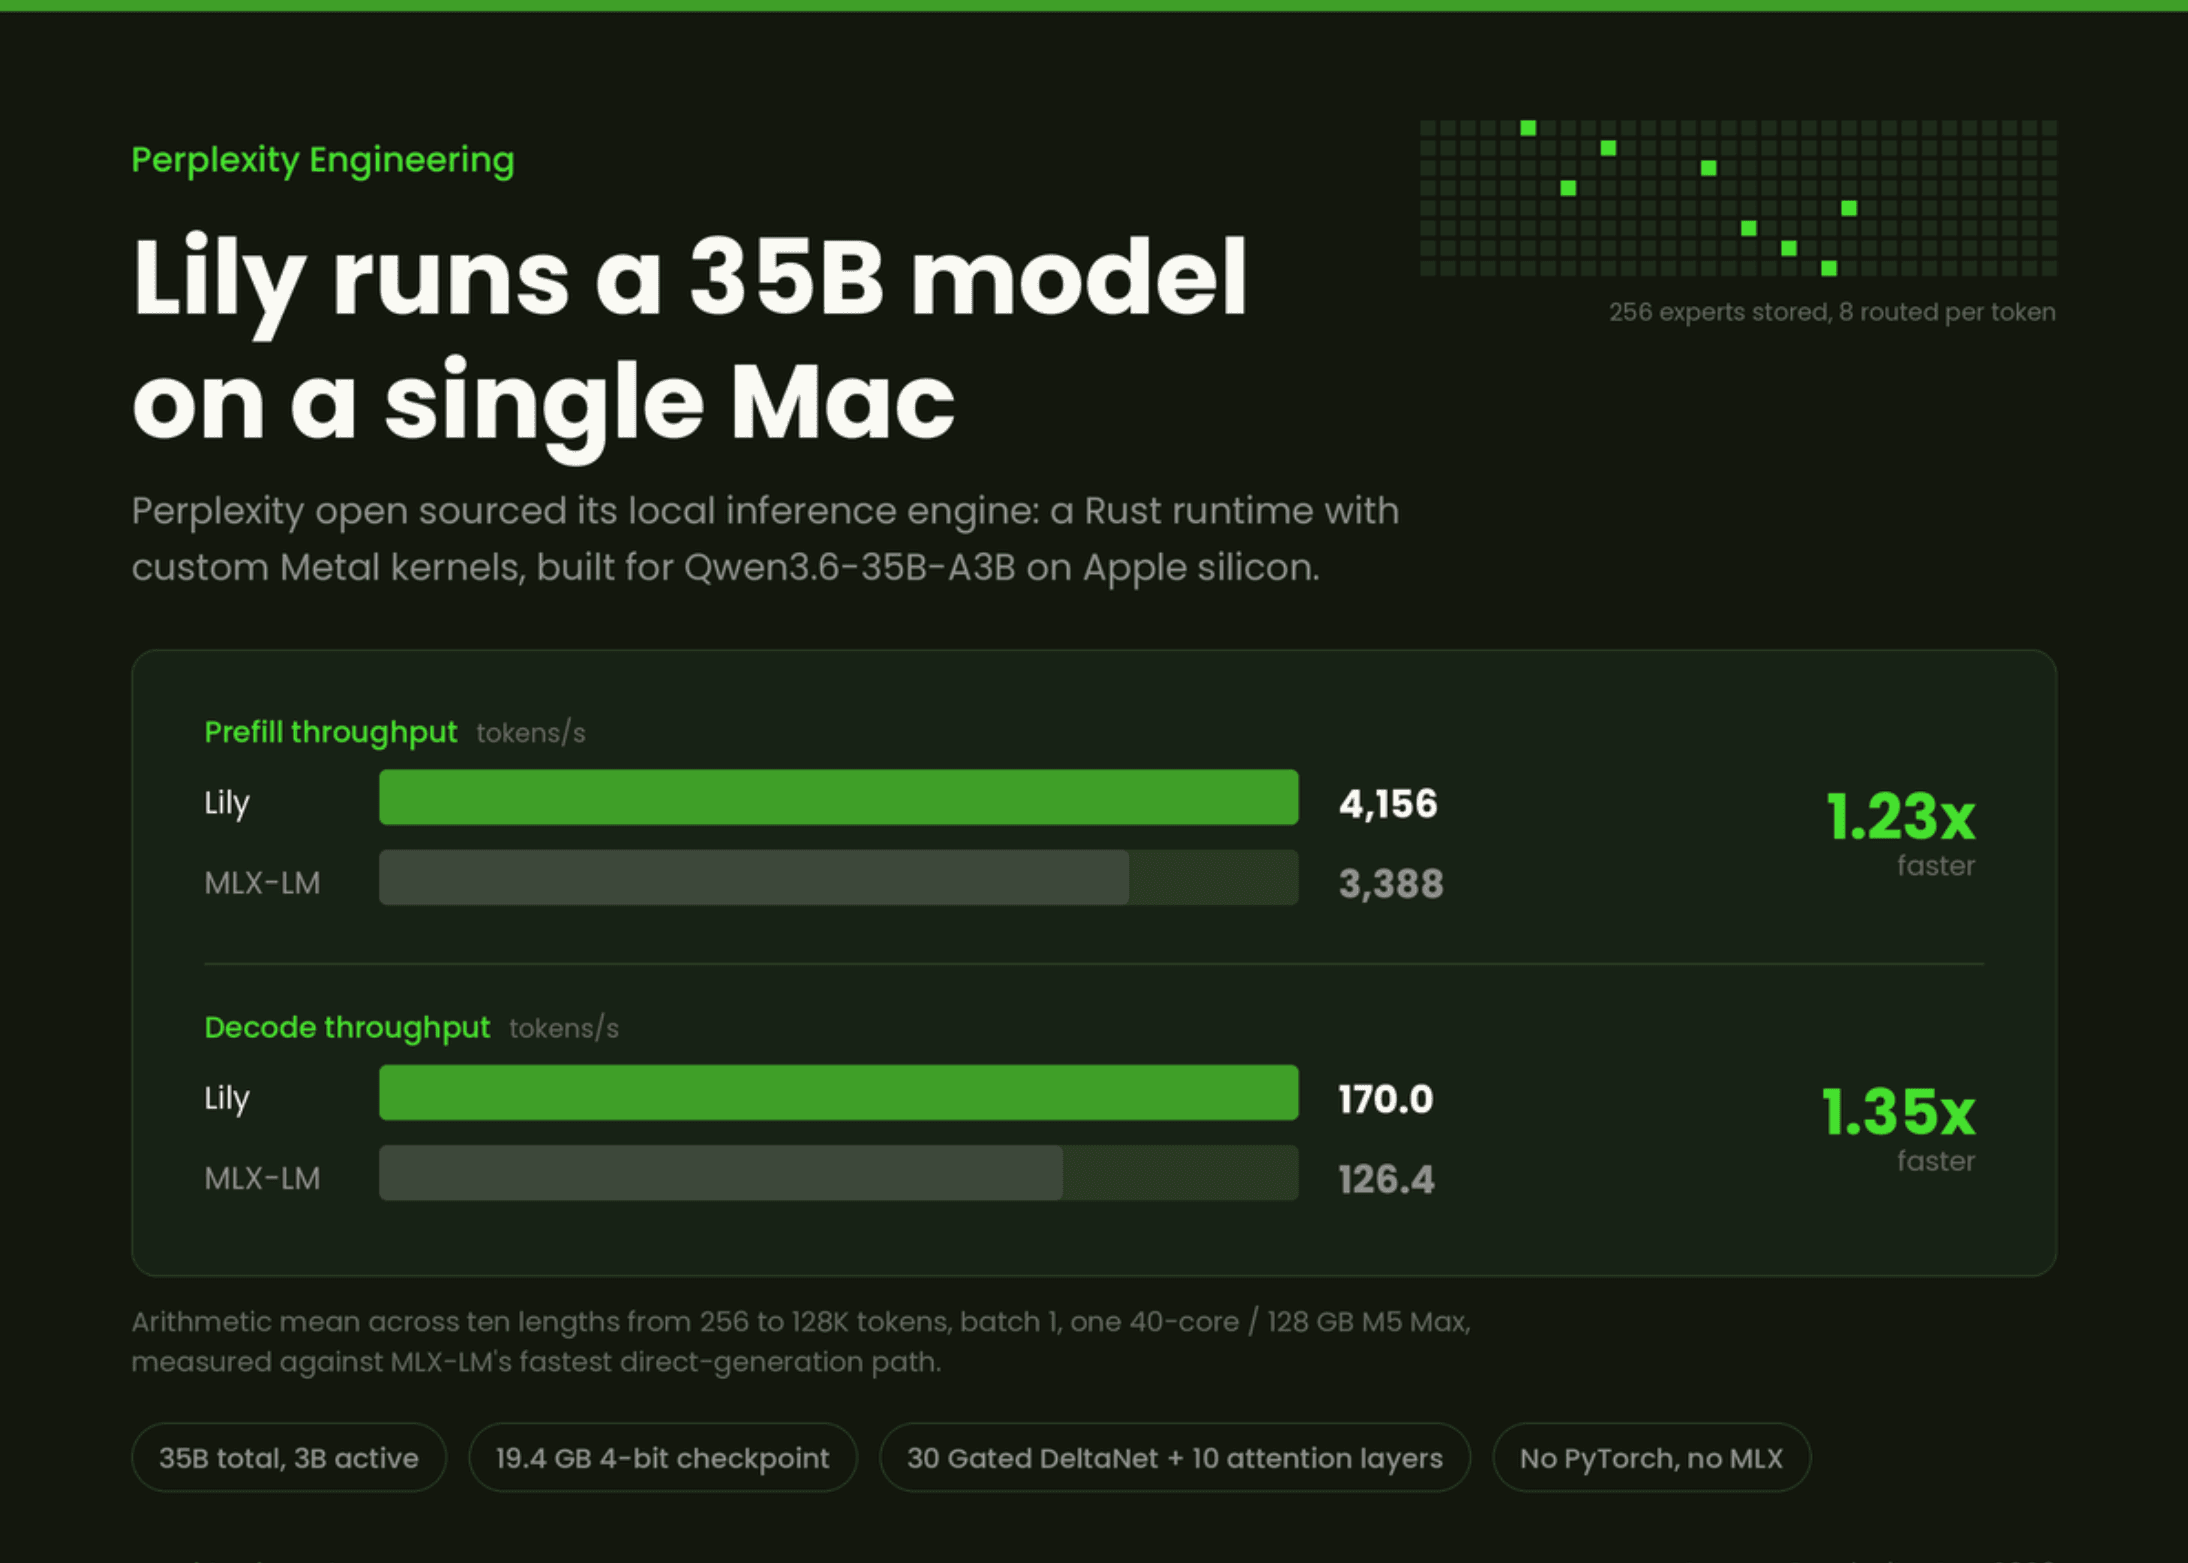
บน M5 Max 40-core พร้อมหน่วยความจำ 128GB ที่ batch 1 และใช้ checkpoint 4-bit ชุดเดียวกัน Lily ทำ prefill เฉลี่ย 4,156 tokens/s เทียบกับ 3,388 ของเส้นทางที่เร็วที่สุดใน MLX-LM 또는 1.23 เท่า ส่วน decode เฉลี่ย 170.0 tokens/s เทียบกับ 126.4 또는 1.35 เท่า ตลอดช่วงความยาว 256 ถึง 128K tokens Lily เร็วกว่าทุกจุดที่บันทึกไว้
ความเร็วเฉพาะทางมีราคาคือขอบเขตแคบ
ข้อควรระวัง: checkpoint แบบ 4-bit มีขนาด 19.4GB ทำให้ Mac ที่มี unified memory 32GB ขึ้นไป เป็นจุดเริ่มต้นที่สมจริง แม้ผลิตภัณฑ์ Hybrid Compute ระบุขั้นต่ำ 24GB นอกจากนี้ benchmark ใช้ M5 Max 128GB จึงไม่ควรคาดว่า Mac รุ่นเริ่มต้นจะได้ตัวเลขเดียวกัน
การตรวจแบบ teacher-forced จำนวน 192 ตำแหน่ง พบ perplexity ของ Lily สูงกว่า 0.04% และให้ token อันดับหนึ่งตรงกับระบบเทียบ 96.35% ของเวลา ตัวเลขนี้บอกว่าการเพิ่มประสิทธิภาพไม่ได้ทำให้ผลตรงกันทุกตำแหน่ง อีกทั้ง Lily รองรับโมเดลและตระกูลฮาร์ดแวร์เดียว ทีมที่ต้องสลับโมเดลบ่อยอาจได้ประโยชน์จาก runtime ทั่วไปมากกว่า แม้ช้ากว่าใน benchmark นี้
ความหมายต่อผู้ประกอบการ/ผู้ใช้งานไทย
ส่วนนี้เป็นความเห็นของสมาคมโดรนไทย: Lily แสดงให้เห็นว่าการรันโมเดลในเครื่องส่วนตัวแทนคลาวด์ต่างประเทศไม่ได้ขึ้นกับขนาดชิปอย่างเดียว การเขียน kernel ให้เข้ากับ memory architecture อาจดึงประสิทธิภาพเพิ่มจากเครื่องเดิมได้ สำหรับทีมไทยที่มี Mac อยู่แล้ว การทดลอง runtime ก่อนซื้อเครื่องใหม่จึงอาจประหยัดกว่าการมองหา GPU หรือ eGPU ทันที
อย่างไรก็ดี unified memory ของ Mac ต้องเลือกตอนซื้อและอัปเกรดภายหลังไม่ได้ ผู้ซื้อควรเผื่อหน่วยความจำให้ checkpoint 19.4GB, KV cache, ระบบปฏิบัติการ และแอปอื่นพร้อมกัน การนำเข้ารุ่น RAM สูงมีต้นทุนมาก การตัดสินใจควรใช้ context และความเร็วที่งานภาษาไทยต้องการจริง ไม่ใช่อ้างผลจากเครื่อง 128GB โดยตรง
สำหรับองค์กรที่ดูแลหลายโมเดล AI server ที่ใช้ NVIDIA และ runtime มาตรฐานอาจยืดหยุ่นกว่า แต่หาก workload ถูกล็อกกับ Qwen3.6-35B-A3B และต้องเก็บข้อมูลในอุปกรณ์ Mac การออกแบบเฉพาะแบบ Lily อาจลด latency ได้ชัดเจน ทางเลือกจึงไม่ใช่เพียงราคาเครื่อง แต่รวมค่าดูแลโค้ดเฉพาะ ความเสี่ยงจากการเปลี่ยนรุ่นโมเดล และความสามารถของทีม Rust/Metal ด้วย
เรียบเรียงจากรายงานของ MarkTechPost และประกาศทางการของ Perplexity